Manual para proteger los pesos de los modelos de IA
A medida que los modelos de inteligencia artificial (IA) de vanguardia —es decir, aquellos que igualan o superan las capacidades de los modelos más avanzados en el momento de su desarrollo— se vuelven más potentes, protegerlos contra el robo y el uso impropio cobra mayor importancia. Son especialmente importantes los pesos de un modelo: los parámetros aprendibles que se obtienen al entrenar el modelo con conjuntos de datos masivos. El robo de los pesos de un modelo permite a los atacantes explotar el modelo para su propio beneficio. La necesidad de proteger los modelos de IA también tiene importantes implicaciones para la seguridad nacional. Los desarrolladores de IA y las partes interesadas de la industria, el gobierno y la sociedad en general necesitan un lenguaje común para evaluar las amenazas, las posturas de seguridad y los resultados en materia de seguridad.
Los investigadores de RAND han elaborado un manual pionero para ayudar a las empresas de IA a defenderse frente a una amplia gama de capacidades de los atacantes, que abarcan incluso los ataques más sofisticados: Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models.1 El informe también pretende facilitar un diálogo significativo entre las partes interesadas sobre las estrategias de gestión de riesgos y el impacto más amplio de la seguridad de la IA.
Este resumen ofrece una visión general del informe, que
- identifica 38 vectores de ataque significativamente distintos
- explora una variedad de capacidades potenciales de los atacantes, desde delincuentes oportunistas hasta Estados nación con amplios recursos
- estima la viabilidad de que un vector de ataque pueda ser ejecutado por diferentes categorías de atacantes
- propone y define cinco niveles de seguridad y recomienda sistemas de seguridad benchmark preliminares que alcancen, a grandes rasgos, dichos niveles de seguridad.
Para evitar brechas de seguridad significativas es necesario implementar de forma exhaustiva un amplio conjunto de prácticas de seguridad. Sin embargo, varias recomendaciones deberían ser prioridades urgentes para las organizaciones de IA de vanguardia:
- Desarrollar un plan de seguridad para un modelo de amenazas exhaustivo.
- Centralizar todas las copias de los pesos en sistemas monitorizados y con control de acceso.
- Reducir el número de personas con acceso a los pesos.
- Reforzar las interfaces de acceso al modelo.
- Emplear una defensa en profundidad para garantizar la redundancia.
- Implementar programas contra amenazas internas.
- Incorporar la computación confidencial para proteger los pesos y reducir la superficie de ataque.
Se necesitan ciertas medidas para protegerse de los atacantes más sofisticados. Estas incluyen limitaciones físicas de ancho de banda entre los dispositivos o redes que contienen los pesos y el mundo exterior; hardware para proteger los pesos de los modelos al tiempo que proporciona una interfaz para la inferencia; y redes seguras y completamente aisladas para el entrenamiento, la investigación y otras interacciones. Dado que la implementación de estos esfuerzos puede tomar un tiempo considerable (por ejemplo, cinco años), sería prudente que las organizaciones comiencen ahora.
¿Por qué centrarse en proteger los sistemas de IA, especialmente los pesos de sus modelos?
Los modelos avanzados de IA prometen aumentar la productividad laboral y mejorar la salud humana. Sin embargo, esta promesa conlleva el riesgo asociado de un uso impropio y de consecuencias no deseadas derivadas de su implementación.
La necesidad de proteger los modelos de IA de vanguardia no es meramente comercial: la preocupación de que los riesgos de los modelos de IA puedan tener repercusiones en la seguridad nacional añade la seguridad y los intereses del público al cálculo de riesgos.
Las amenazas potenciales son sofisticadas, en particular las operaciones de alta prioridad llevadas a cabo por Estados nación. Las organizaciones desarrollan sus propias estrategias de seguridad basándose en su evaluación de las amenazas. Sin embargo, la visión particular del equipo de seguridad de una organización podría tener implicaciones que trascienden a la propia organización. Todas las partes interesadas deben compartir una visión común de cómo las estrategias de seguridad, ya sean voluntarias o gubernamentales, se traducen en seguridad real.
El análisis del equipo de investigación se centró en las formas de prevenir el robo de los pesos de los modelos, los parámetros aprendibles de los modelos de IA. Los pesos de un modelo de IA representan la culminación de muchos requisitos previos costosos para el entrenamiento de modelos avanzados de IA: una inversión significativa en poder de cómputo, grandes cantidades de datos de entrenamiento y años de investigación por parte de los mejores talentos para optimizar los algoritmos. Si los atacantes disponen de los pesos de un modelo, tienen control total sobre él.
El equipo de investigación analizó diversas fuentes escritas procedentes de la literatura académica, informes comerciales de seguridad, documentos oficiales del gobierno, informes de los medios de comunicación y otras fuentes en línea. También realizaron entrevistas a casi tres docenas de expertos, entre ellos personal de seguridad nacional del gobierno especializado en seguridad de la información, destacados expertos del sector de la seguridad de la información, personal de alto nivel en seguridad de la información de empresas de IA de vanguardia, otros altos cargos de empresas de IA de vanguardia, expertos independientes en IA con experiencia previa en organizaciones de IA de vanguardia y expertos en amenazas internas.
¿Cuáles son las posibles vías de ataque?
El equipo de investigación identificó 38 vectores de ataque que los posibles atacantes podrían utilizar para robar los pesos de los modelos. Los vectores no son meramente teóricos: la gran mayoría ya se ha utilizado. La tabla 1 describe cinco vectores de ataque comunes y ofrece ejemplos de su uso. Los ejemplos ilustran la amplitud de las capacidades de ataque, desde las increíblemente comunes y sencillas —como colocar memorias USB en estacionamientos— hasta los ataques más sofisticados, como el desarrollo de herramientas criptoanalíticas revolucionarias que solo los actores más capacitados pueden lograr.
Estos ejemplos ofrecen un perfil intuitivo de las capacidades de los diferentes tipos de actores. El informe completo proporciona descripciones detalladas de los ataques y cientos de ejemplos.
Tabla 1. Cinco vectores de ataque comunes
| Tipo de ataque | Enfoque de ejemplo | Caso real |
|---|---|---|
| Ingeniería social | Phishing: un atacante puede engañar a un usuario legítimo para que ejecute código malicioso o comparta inadvertidamente sus credenciales de autenticación, superando incluso la autenticación multifactor. | Se estima que el phishing es responsable de una pérdida global anual de 6900 millones de dólares.2 El phishing avanzado se ofrece como servicio por tan solo 400 dólares al mes.3 |
| Colocación maliciosa de dispositivos portátiles | Colocación de memorias USB «perdidas»: los hackers pueden «dejar caer» dispositivos USB en los estacionamientos de las organizaciones de interés. Tarde o temprano, algún empleado conecta la memoria USB a su computadora del trabajo para averiguar quién la dejó, lo que permite al hacker ejecutar código en una red interna. Incluso se pueden comprar cables USB por 180 dólares que proporcionan el control remoto de una computadora.4 | Varias instalaciones nucleares de EE. UU. han sido infectadas con éxito con malware mediante memorias USB «perdidas».5 |
| Vectores de ataque específicos de la IA | La infraestructura específica de la IA tiende a tener dependencias muy extensas y evoluciona más rápido que la mayor parte del resto del software, lo que la hace aún más vulnerable a los ataques a la cadena de suministro. Los atacantes pueden introducir intencionalmente vulnerabilidades en paquetes de código abierto que se utilizan en la infraestructura común de aprendizaje automático. | PyTorch, posiblemente el marco de desarrollo de aprendizaje automático más común del mundo, se vio comprometido por un paquete de software de código abierto malicioso que importó.6 |
| Acceso físico no autorizado a los sistemas | Los atacantes especialmente capacitados no solo pueden irrumpir en la ubicación de un dispositivo, sino también penetrar diversos tipos de seguridad de hardware. Un método consiste en utilizar el voltage glitching: alteraciones en el voltaje suministrado a un chip que provocan su mal funcionamiento y la divulgación de información que debería ser segura. | Se descubrió que los chips de AMD, fabricante de aproximadamente el 23 % de todos los chips para computadoras de escritorio y servidores a nivel mundial, eran vulnerables a un ataque de «voltage glitching».7 |
| Socavar el propio sistema de control de acceso | Los actores extremadamente capacitados pueden encontrar y explotar vulnerabilidades en los componentes criptográficos fundamentales que subyacen a los sistemas de cifrado, autenticación y control de acceso de uso generalizado. La explotación de estas vulnerabilidades socavaría muchos de los supuestos en los que se basan la mayoría de los sistemas de seguridad. | El método de «criptoanálisis diferencial», descrito por Eli Biham y Adi Shamir en 1991,8 socavó amplios sectores de los sistemas de cifrado y autenticación: la mayoría de los sistemas que no habían sido diseñados específicamente para evitarlo. Más tarde se reveló que IBM descubrió este tipo de ataque ya en 1974, solo para enterarse de que la Agencia de Seguridad Nacional ya lo conocía desde antes.9 |
Debido a que los vectores de ataque son tan diversos y numerosos, las defensas deben ser variadas y exhaustivas; lograr una seguridad sólida frente a una categoría de ataque específica no protege a una organización frente a otras.
Además, los ejemplos de ataques conocidos públicamente son solo un subconjunto de los ataques reales. En las entrevistas del equipo de investigación, muchos expertos en seguridad nacional señalaron que la gran mayoría de los ataques de actores estatales con grandes recursos de los que tienen conocimiento nunca se revelaron públicamente.
¿Cuáles son las necesidades de seguridad de los diferentes sistemas de IA?
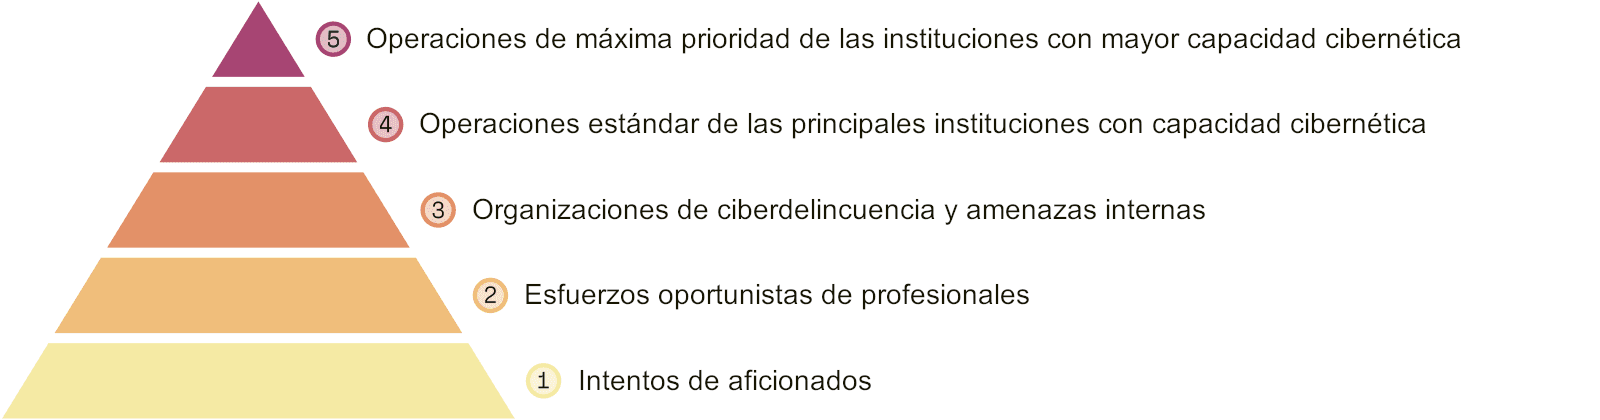
Para facilitar un debate más matizado sobre las necesidades de seguridad de los diferentes sistemas de IA, Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models propone cinco niveles de seguridad (SL), definidos en términos generales como el nivel de seguridad necesario para evitar operaciones cada vez más avanzadas:
- SL 1 puede proteger contra intentos de principiantes: hackers aficionados y ataques no dirigidos de tipo «spray and pray».
- SL 2 probablemente pueda dificultar los esfuerzos oportunistas de los profesionales: tanto de hackers profesionales individuales como de grupos que ejecutan ataques no dirigidos o de menor prioridad.
- SL 3 ofrece protección frente a las organizaciones de ciberdelincuencia y las amenazas internas. Esto incluye a grupos de hackers criminales de renombre mundial, organizaciones terroristas con abundantes recursos y empleados descontentos.
- SL 4 puede frustrar las operaciones estándar de las principales instituciones con capacidad cibernética: por ejemplo, muchos de los principales grupos patrocinados por Estados y agencias de inteligencia.
- SL 5 puede frustrar los ataques menos comunes, pero más peligrosos: operaciones de máxima prioridad llevadas a cabo por los Estados nación más capaces del mundo.
¿Cómo pueden las organizaciones de IA implementar medidas de seguridad proporcionales al riesgo?
Tras consultas iterativas con expertos, el equipo definió un sistema de benchmark para cada SL. El sistema ofrece una herramienta aproximada para calibrar las relaciones entre la implementación de medidas de seguridad y los resultados de seguridad esperados. Los benchmarks sugieren medidas y políticas concretas que, según se estima, constituyen los requisitos mínimos de un sistema que se ajusta a los objetivos de ese nivel de seguridad. Los benchmarks no son un estándar completo ni un régimen de cumplimiento. Ofrecen a las organizaciones sugerencias concretas sobre los próximos pasos a seguir.
Varios laboratorios de IA estimaron que, si se priorizara este esfuerzo, se tardaría aproximadamente un año en alcanzar el SL 3; entre dos y tres años en lograr el SL 4; y al menos cinco años, además del apoyo de la comunidad de seguridad nacional, en alcanzar el SL 5. A continuación, ofrecemos algunos comentarios seleccionados del debate sobre los SL en el informe completo.
Tabla 2. Benchmarks de los niveles de seguridad
| Benchmark | Descripción general |
|---|---|
| SL 1 | En este nivel, las organizaciones deben basarse en los productos de seguridad existentes y en las mejores prácticas en lugar de intentar desarrollar soluciones propias. El SL 1 proporciona una seguridad fiable únicamente frente a los atacantes más triviales. |
| SL 2 | La principal preocupación en este nivel es implementar los aspectos fundamentales de manera exhaustiva en todos los ámbitos, asegurando que no queden «puntos ciegos» desatendidos. Es clave dar prioridad a los vectores de ataque más comunes: por ejemplo, garantizar que la seguridad del correo electrónico, las políticas de contraseñas y la autenticación multifactor se apliquen correctamente. |
| SL 3 | En este nivel, un objetivo clave es reducir los riesgos derivados de las amenazas internas (por ejemplo, los empleados de la empresa), reduciendo así simultáneamente el riesgo de los atacantes que se hacen pasar por personal interno u obtienen acceso ilegítimo a los dispositivos digitales de los empleados. La mitigación de estos riesgos incluye reducir el número de personas autorizadas a acceder a los pesos del modelo, reforzar sus interfaces de acceso e implementar la defensa en profundidad. El benchmark incluye la supervisión y la protección de toda la cadena de suministro: software, hardware e incluso sistemas de aire acondicionado. |
| SL 4 | El resto de la superficie crítica para la seguridad puede reforzarse, revisarse, supervisarse y someterse a pruebas de penetración de forma exhaustiva. Esto requiere importantes concesiones en materia de productividad, comodidad y eficiencia. Debe implementarse la computación confidencial para proteger los pesos en uso. Dado que los actores estatales cuentan con amplias capacidades, el equipo de seguridad debe tener experiencia específica en el trato con dichos actores. |
| SL 5 | Salvo para su uso en producción, los pesos se almacenan en una configuración completamente aislada y desconectada del mundo exterior, con políticas extremadamente estrictas sobre la transferencia de datos que impiden incluso a quienes cuentan con acceso autorizado sacar grandes cantidades de datos de la sala. Se necesita más investigación y desarrollo para que las organizaciones puedan dar soporte a modelos en producción al tiempo que cumplen los requisitos de seguridad del SL 5. Actualmente no es posible alcanzar el SL 5. |
Medidas de seguridad recomendadas
Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models describe 167 medidas de seguridad recomendadas que conforman los benchmarks de seguridad. Este informe ofrece dos ejemplos: una pequeña muestra de las numerosas medidas importantes y viables que las organizaciones pueden adoptar para proteger los pesos de sus modelos.
Refuerzo de las interfaces de acceso a los pesos
En muchos de los principales laboratorios, cientos o miles de personas tienen acceso completo de «lectura» a los pesos de los modelos de vanguardia. Cualquiera de esas personas puede hacer una copia de los pesos, que luego podría vender o difundir. Por lo general, estas personas necesitan utilizar los pesos para su trabajo, pero la gran mayoría no necesita la capacidad de copiarlos. Esta medida de seguridad recomendada garantiza que los usuarios autorizados interactúen con los pesos a través de una interfaz de software que reduce el riesgo de que sean copiados de forma ilegítima.
Combinar tres sencillos tipos de acceso podría adaptarse a los diversos tipos de acceso de los empleados y, al mismo tiempo, reducir de manera significativa el riesgo de exfiltración:
- Uso de código predefinido, revisado y aprobado por el equipo de seguridad. Esta es la opción más lógica para las interfaces de inferencia (tanto a nivel interno como para las interfaces de programación de aplicaciones [API] públicas).
- Acceso más flexible (incluida la ejecución de código personalizado) en un servidor con salidas con tasa limitada, de modo que la extracción de una parte significativa de los pesos tomaría demasiado tiempo como para ser viable. Esto podría utilizarse para la mayoría de los casos de uso en investigación y desarrollo.
- Trabajo directo (sin restricciones en el código ni en las tasas de datos de salida) en una computadora aislada con separación física. Esto puede resultar útil en casos excepcionales en los que se necesite una flexibilidad total, posiblemente al realizar investigaciones sobre interpretabilidad directamente en modelos de vanguardia.
Computación confidencial
Aunque los pesos del modelo (y otros datos sensibles) estén cifrados durante su transporte y almacenamiento, se descifran y quedan vulnerables al robo durante su uso. Muchos empleados, así como ciberatacantes con una presencia mínimamente persistente, pueden robar los pesos una vez que se descifran antes de su uso previsto. La computación confidencial es una técnica para garantizar que los datos permanezcan seguros, incluso durante su uso, al descifrarlos únicamente dentro de un entorno de ejecución de confianza (TEE) basado en hardware que no ejecutará código inseguro. Implementar la computación confidencial para proteger los pesos de los modelos de IA podría reducir significativamente la probabilidad de que sean robados.
Sin embargo, la computación confidencial debe implementarse correctamente:
- El TEE debe incluir protecciones contra ataques físicos (las implementaciones actuales de computación confidencial en unidades de procesamiento gráfico [GPU] no las incluyen).
- Los pesos del modelo deben cifrarse mediante una clave generada dentro del TEE y almacenada en este.
- El TEE solo ejecutará código firmado, preespecificado y auditado. Dicho código descifra los pesos, realiza la inferencia y genera como salida únicamente la respuesta del modelo. El código no puede generar como salida los pesos, la clave de cifrado de los pesos ni ninguna información producida directamente por el modelo.
El uso de la computación confidencial en las GPU aún es incipiente y puede que no esté listo para producción en sistemas de vanguardia. Sin embargo, existe un consenso abrumador entre los expertos respecto a su importancia y se espera que se implemente en breve.
¿Cómo pueden utilizar Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models las partes interesadas?
Existe un debate animado y en curso sobre hasta qué punto es necesario proteger los diferentes modelos (si es que hay que hacerlo). El objetivo del equipo de investigación era mejorar la capacidad de proteger aquellos modelos de IA de vanguardia que se consideren dignos de protección al nivel de seguridad (SL) deseado, sistematizando el conocimiento sobre qué posturas de seguridad logran diversos resultados deseables, específicamente en el contexto de la protección de los sistemas de IA y los pesos de sus modelos. Securing AI Model Weights: Preventing Theft and Misuse of Frontier Models respalda la toma de decisiones informadas tanto en el sector privado como en el público:
- Los directivos y los equipos de seguridad de las principales empresas de IA pueden explorar los vectores de ataque descritos en el informe y los numerosos casos documentados de su uso. Muchos de los expertos en seguridad entrevistados por el equipo de investigación conocían algunos vectores de ataque, pero desconocían otros o se mostraban escépticos ante ellos. Esta brecha de conocimiento puede dejar sus sistemas vulnerables.
- Las empresas de IA también deberían comparar su postura de seguridad actual con los cinco benchmarks de seguridad. Al identificar qué benchmark se acerca más a su estado actual, pueden comprender mejor contra qué actores es probable que estén protegidos y, lo que es más importante, cuáles siguen representando una amenaza. Los benchmarks no son prescriptivos y sus detalles irán evolucionando, pero constituyen una herramienta de calibración útil.
- Las empresas pueden utilizar los benchmarks de seguridad para identificar los próximos pasos a seguir en la mejora de su postura de seguridad. Si a las empresas les faltan medidas de seguridad específicas (o alternativas que tengan más sentido para su infraestructura) para cumplir un benchmark concreto, deberían centrarse primero en ellas. Una vez que hayan alcanzado un benchmark de seguridad, podrán pasar al siguiente en busca de nuevas recomendaciones y próximos pasos.
- Los benchmarks de seguridad también podrían servir de base para normas y regulaciones, proporcionando a los reguladores y a los directivos un fundamento de conceptos y medidas para evaluar qué nivel de seguridad han alcanzado las empresas o tienen previsto alcanzar.