Escalamiento: el panorama actual de la IA
Una breve pausa intergeneracional
Me parece que es un buen momento para analizar en qué punto nos encontramos con respecto a la IA y qué nos depara el futuro. Quiero centrarme exclusivamente en las capacidades de los modelos de IA y, en concreto, en los modelos de lenguaje a gran escala que son la base de chatbots como ChatGPT y Gemini. Estos modelos se vuelven cada vez más «inteligentes» con el tiempo, y parece que vale la pena analizar el por qué, ya que eso nos ayudará a comprender lo que vendrá después. Para ello, es necesario profundizar en la manera en se entrenan los modelos. Voy a tratar de explicarlo sin entrar en tecnicismos, así que ignoraré muchos matices importantes; espero que mis lectores más versados en la materia me disculpen.
Escalamiento del tamaño del modelo: la «gran escala» de los modelos de lenguaje a gran escala
Para comprender en qué punto nos encontramos con los LLM, es necesario entender el concepto de escala. Como ya he advertido, voy a simplificar bastante las cosas, pero existe una «ley de escalamiento» (en realidad, más bien una observación) en la IA que sugiere que cuanto más grande es un modelo, mayor es su capacidad. Los modelos más grandes tienen un mayor número de parámetros, que son los valores ajustables que el modelo utiliza para predecir qué escribir a continuación. Estos modelos suelen entrenarse con mayores cantidades de datos, medidos en tokens, que en el caso de los LLM suelen ser palabras o partes de palabras. El entrenamiento de estos modelos más grandes requiere un mayor poder de cómputo, que a menudo se mide en FLOP (operaciones de coma flotante). Los FLOP miden el número de operaciones matemáticas básicas (como sumas o multiplicaciones) que realiza una computadora, lo que nos permite cuantificar el trabajo computacional realizado durante el entrenamiento de la IA. Los modelos más capaces son aquellos que están mejor preparados para realizar tareas complejas, obtienen mejores resultados en benchmarks y exámenes, y, en general, parecen ser «más inteligentes».
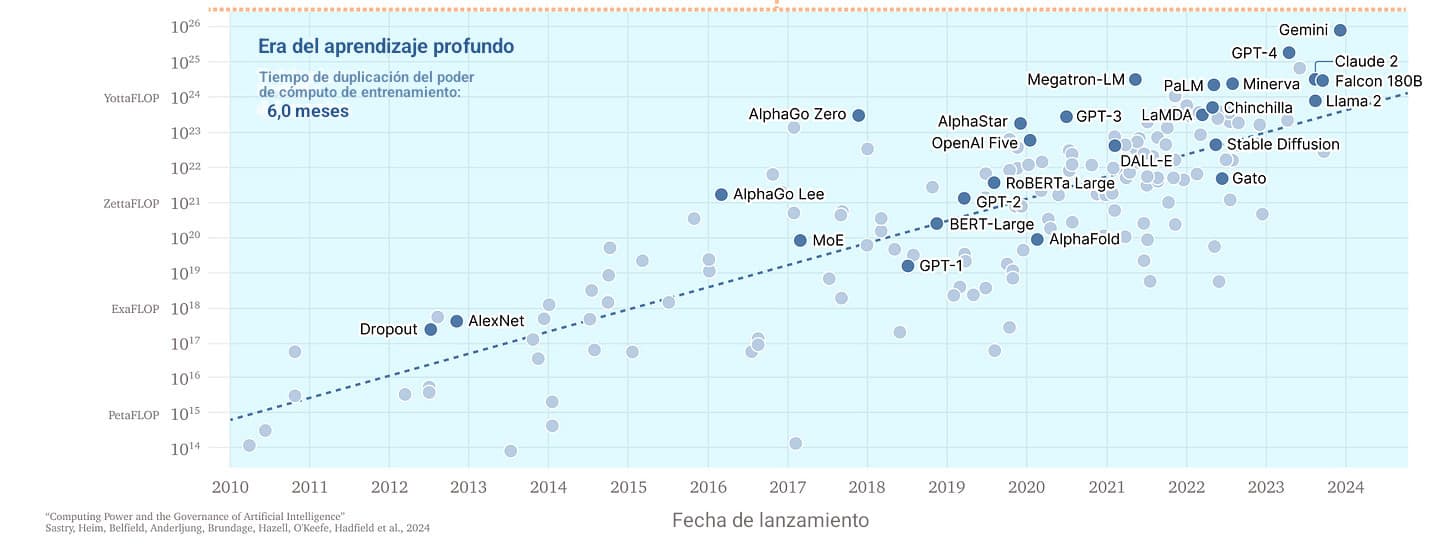
La escala sí que importa. Bloomberg creó BloombergGPT para aprovechar sus vastos recursos de datos financieros y, potencialmente, obtener una ventaja en el análisis financiero y la pronosticación. Se trataba de una IA especializada, entrenada con grandes cantidades de datos de alta calidad de Bloomberg y con 200 ZetaFLOP (es decir, 2 x 10^23) de poder de cómputo. Era bastante buena en tareas como determinar el tono de los documentos financieros… pero, en general, fue superada por GPT-4, que no había sido entrenado en absoluto para finanzas. GPT-4 era simplemente un modelo más grande (se estima que 100 veces mayor, con 20 YottaFLOP, alrededor de 2 x 10^25) y, por lo tanto, suele ser mejor que los modelos pequeños en todo. Este tipo de escalamiento parece mantenerse para todo tipo de trabajo productivo; en un experimento en el que traductores pudieron utilizar modelos de diferentes tamaños, «por cada aumento de 10 veces en el poder de cómputo del modelo, los traductores completaban las tareas un 12,3 % más rápido, obtenían calificaciones 0,18 desviaciones estándar más altas y ganaban un 16,1 % más por minuto».
Los modelos más grandes también requieren más esfuerzo para su entrenamiento. Esto no se debe solo a que sea necesario recopilar más datos, sino también a que los modelos más grandes requieren más tiempo de cálculo, lo que a su vez exige más chips de computadora y más energía para hacerlos funcionar. El patrón de mejora se produce en órdenes de magnitud. Para obtener un modelo mucho más capaz, es necesario aumentar, en un factor de diez aproximadamente, la cantidad de datos y el poder de cómputo necesarios para el entrenamiento. Eso también tiende a incrementar el costo en un orden de magnitud.
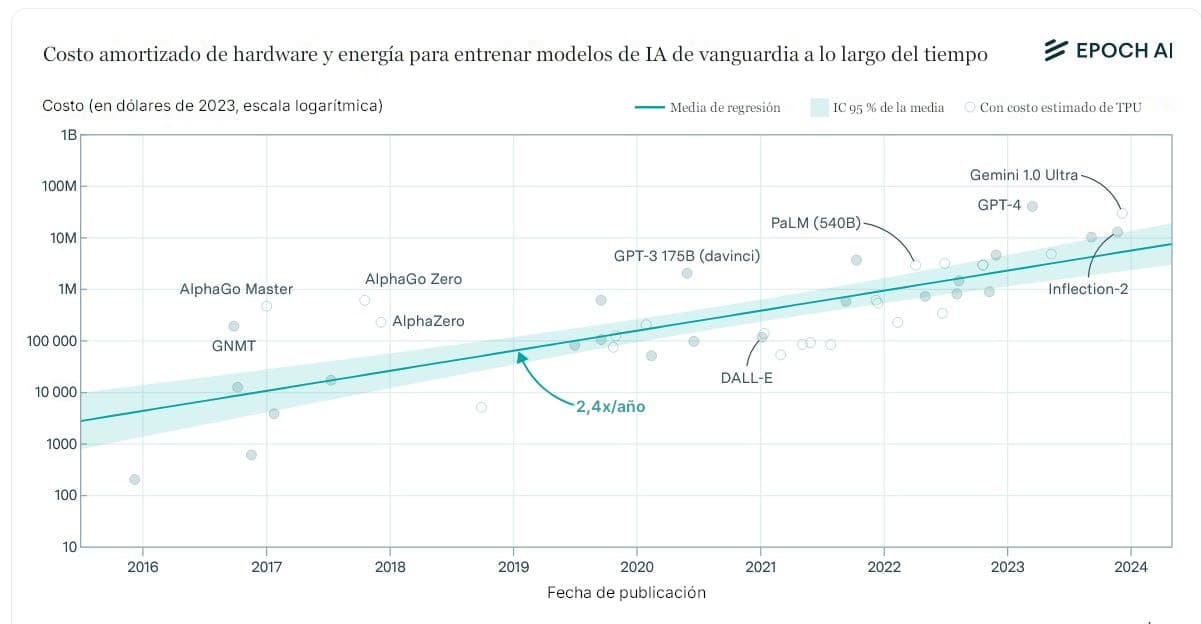
Como se puede ver, muchos aspectos de la escala están relacionados, pero implican una sopa de letras de medidas y términos. Esto genera confusión, y no ayuda que las empresas de IA sean tan reservadas respecto a sus modelos y les asignen nombres crípticos que dificultan comprender de lo que son capaces. Pero podemos simplificarlo un poco: la historia de la capacidad de la IA ha sido, en gran medida, la historia de la ampliación de la escala de los modelos, cuyo crecimiento sigue un enfoque generacional. Cada generación requiere mucha planificación y dinero para reunir los datos y el poder de cómputo —unas diez veces más que en la anterior— necesarios para entrenar un modelo más grande y mejor. A los modelos de mayor escala en un momento dado los llamamos «modelos de vanguardia».
Por lo tanto, en aras de la simplicidad, me permito proponer las siguientes etiquetas muy aproximadas para los modelos de vanguardia. Nótese que estas etiquetas generacionales son mi propia categorización simplificada para ayudar a ilustrar la progresión de las capacidades de los modelos, y no la terminología oficial de la industria:
-
Modelos de primera generación (2022): son modelos con la capacidad de ChatGPT-3.5, el modelo de OpenAI que desencadenó el torbellino de la IA generativa. Requieren menos de 10^25 FLOP de poder de cómputo y su costo de entrenamiento suele ser de 10 millones de dólares o menos. Existen muchos modelos de primera generación, incluyendo versiones de código abierto.
-
Modelos de segunda generación (2023-2024): son modelos con la capacidad de GPT-4, el primer modelo de su clase. Requieren aproximadamente entre 1025 y 1026 FLOP de poder de cómputo y su entrenamiento podría tener un costo de 100 millones de dólares o más. Actualmente existen múltiples modelos de segunda generación.
-
Modelos de tercera generación (2025?-2026?): por el momento, no hay modelos de tercera generación disponibles, pero sabemos que pronto se lanzarán varios de ellos, incluidos GPT-5 y Grok 3. Requieren entre 1026 y 1027 FLOP de poder de cómputo y mil millones de dólares (o más) para su entrenamiento.
-
Modelos de cuarta generación y más allá: es probable que veamos modelos de cuarta generación en un par de años, y su entrenamiento podría tener un costo de más de 10 000 millones de dólares. Algunos expertos con los que he hablado esperan que los beneficios del escalamiento terminen antes de la cuarta generación, como mínimo. A partir de ahí, podría ser posible que la escala aumente 1000 veces más allá de la tercera generación para finales de la década, pero no está claro. Por eso hay tanto debate sobre cómo obtener la energía y los datos necesarios para alimentar los modelos futuros.
GPT-4 dio inicio a la era de la segunda generación, pero ahora otras empresas lo han alcanzado, y estamos a las puertas de los primeros modelos de tercera generación. Quiero centrarme en el estado actual de la segunda generación, donde cinco IA, en particular, llevan la delantera.
Los cinco (más o menos) modelos de vanguardia de segunda generación
Aunque hay otros modelos que podrían considerarse de segunda generación, hay cinco que dominan sistemáticamente las comparaciones directas. Estos cinco modelos de vanguardia presentan muchas diferencias, pero, como todos se encuentran dentro de un mismo orden de magnitud entre sí, tienen niveles de «inteligencia» más o menos similares. Quiero analizar cada uno de ellos, y les haré a todos las mismas tres preguntas para ilustrar sus capacidades:
-
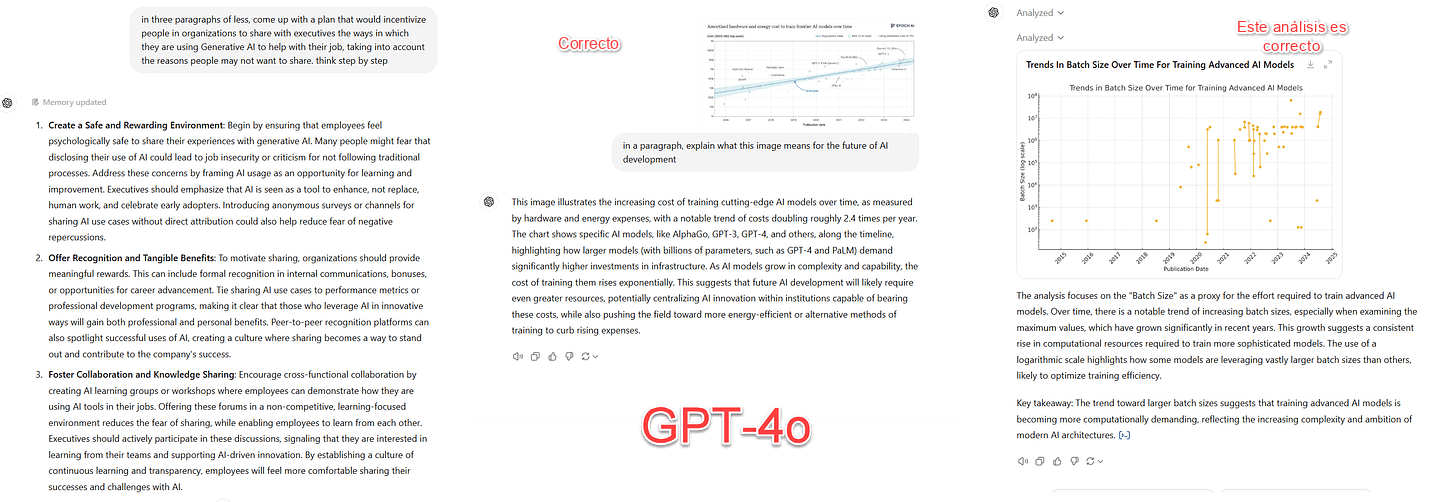
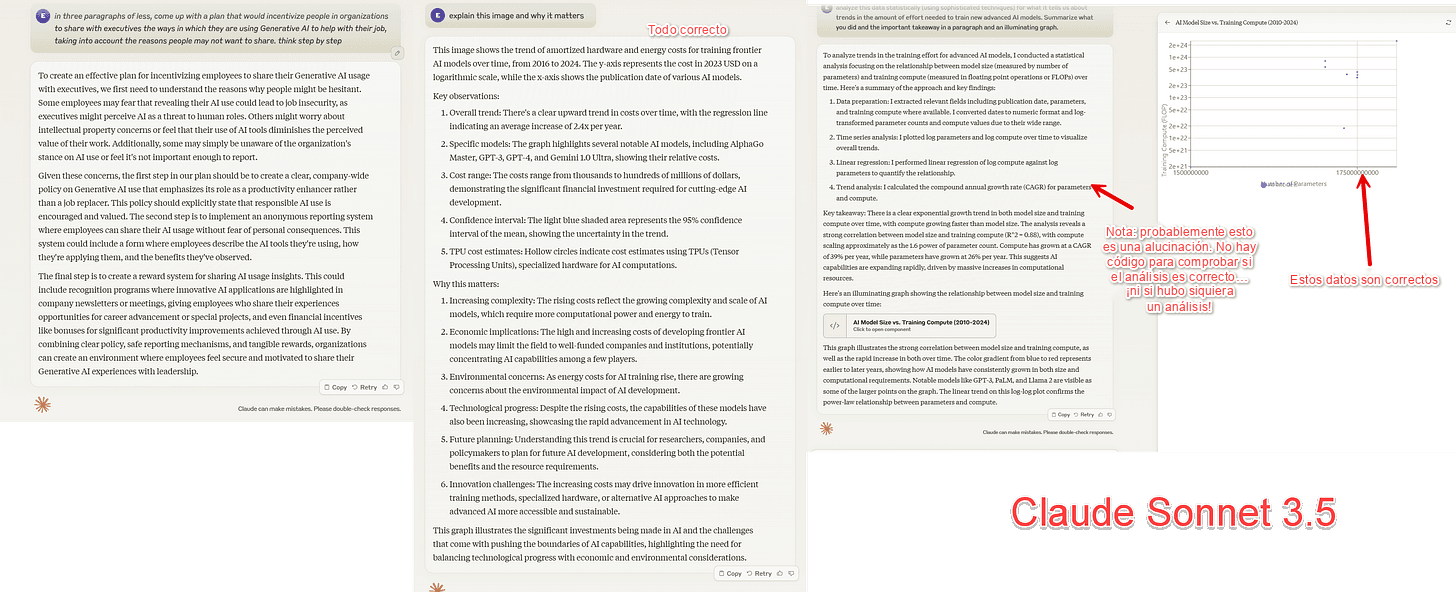
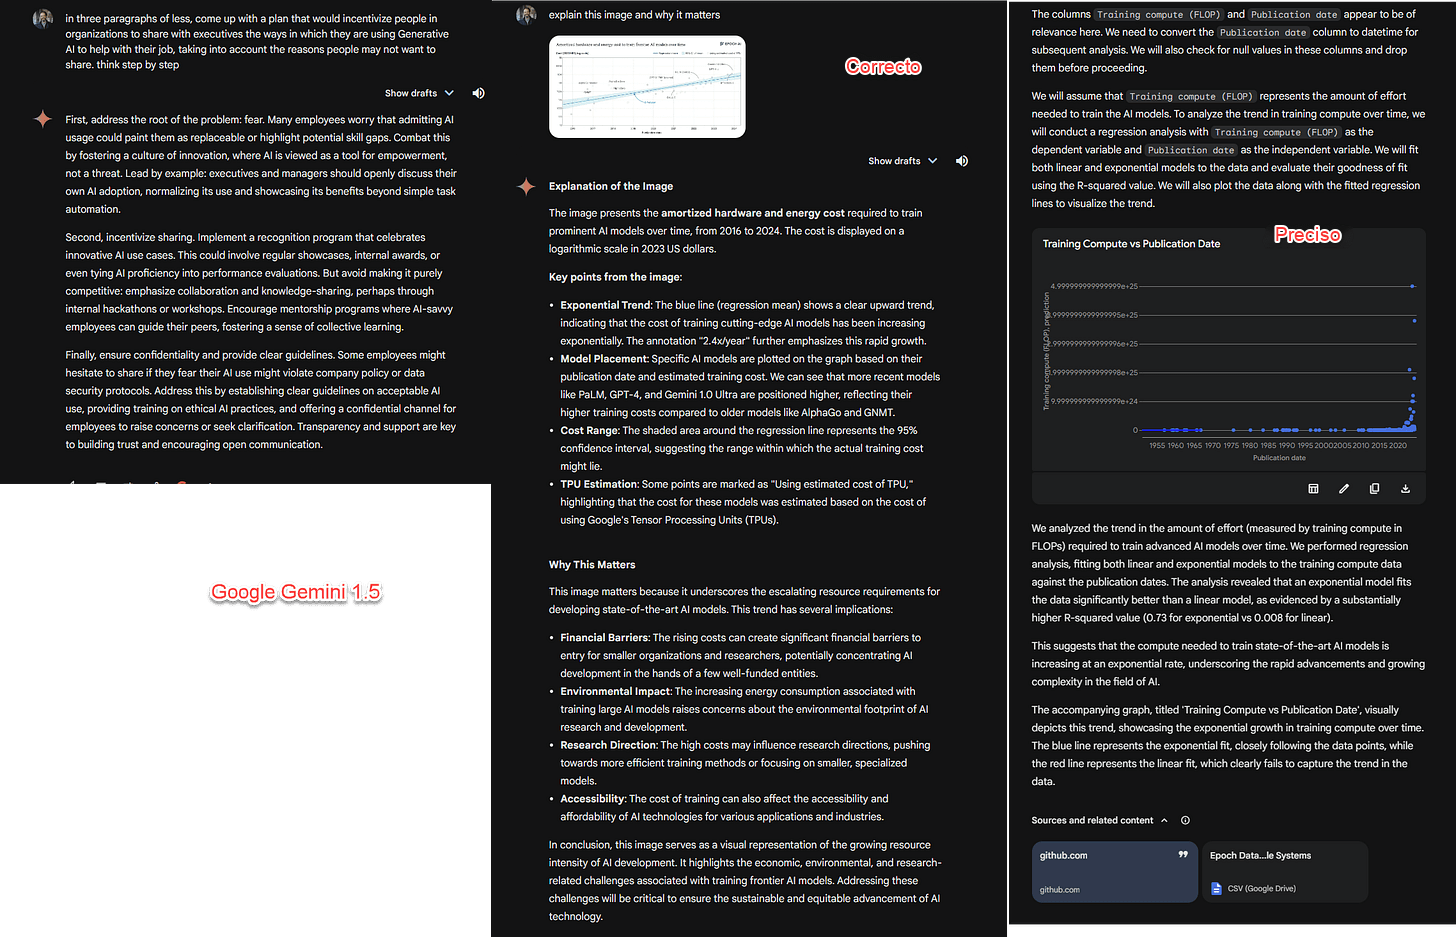
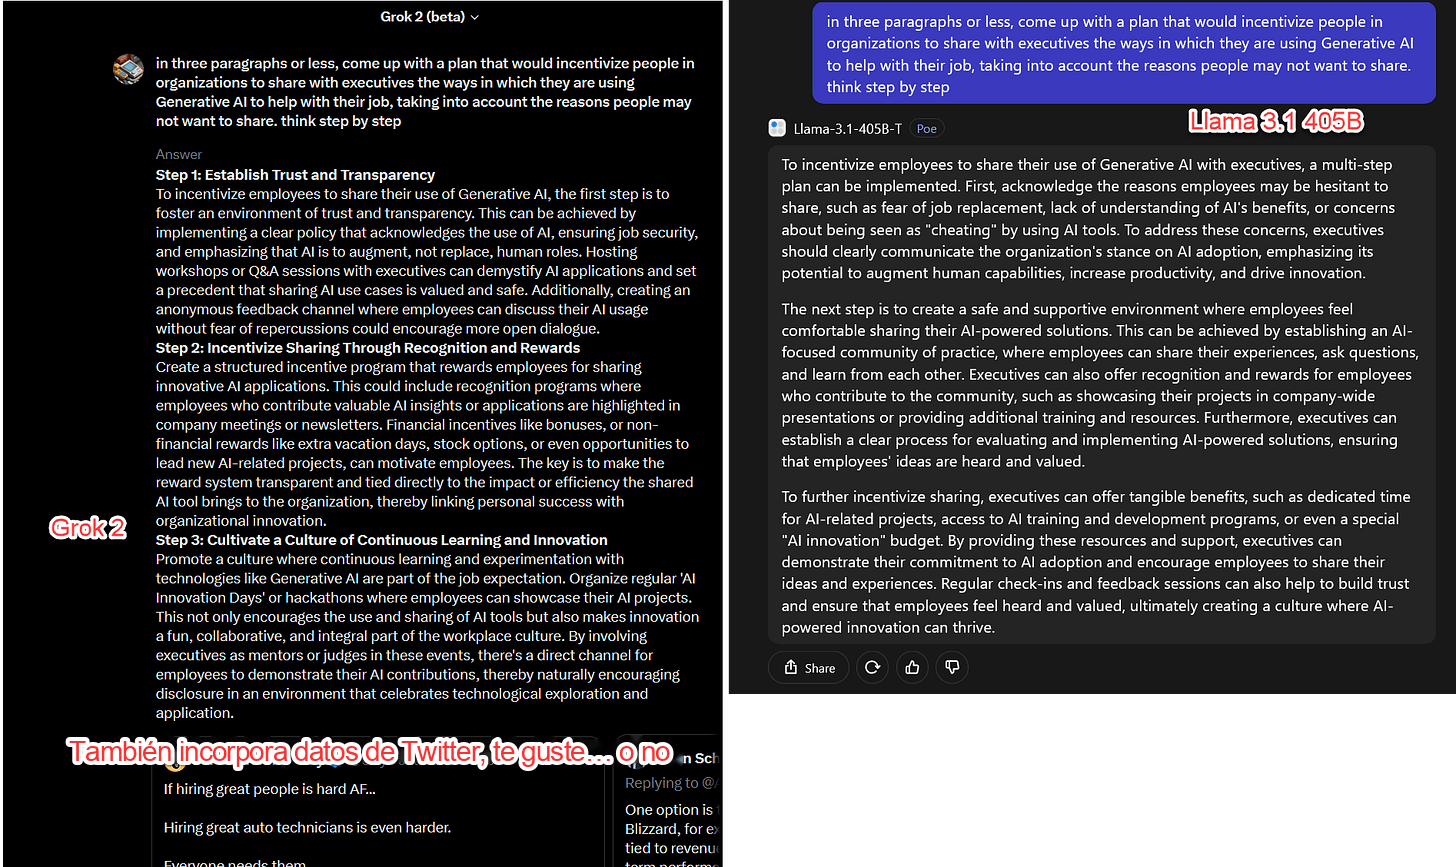
en tres párrafos o menos, elabora un plan que incentive a las personas en las organizaciones a compartir con la dirección cómo están usando la IA generativa para ayudarse en su trabajo, teniendo en cuenta las razones por las que podrían no querer compartirlo. piensa paso a paso
-
explica esta imagen y por qué es importante [Pegué el gráfico de arriba sobre los costos de entrenamiento.]
-
Analiza estos datos estadísticamente (con técnicas sofisticadas) para determinar qué nos indican sobre las tendencias de la cantidad de esfuerzo que se necesita para entrenar nuevos modelos avanzados de IA. Resume lo que hiciste e incluye la conclusión principal en un párrafo y un gráfico ilustrativo. [Pegué un enorme conjunto de datos sobre los detalles de entrenamiento de cientos de modelos en un archivo CSV.]
GPT-4o. Este es el modelo que impulsa a ChatGPT, así como a Microsoft Copilot. También es el que cuenta con más funcionalidades de todos los modelos de vanguardia actuales y ha sido el modelo líder en comparaciones directas. Es multimodal, lo que significa que puede trabajar con datos de voz, imágenes y archivos (incluidos PDF y hojas de cálculo), y es capaz de programar. También puede generar voz, archivos e imágenes (utilizando un generador de imágenes integrado, DALL-E3). Además, puede realizar búsquedas en la web y ejecutar código a través de Code Interpreter. A diferencia de otros modelos que utilizan la voz, GPT-4o tiene un modo de voz avanzado que es mucho más potente, ya que el propio modelo escucha y habla; otros modelos utilizan la conversión de texto a voz, donde tu voz se convierte en texto y luego se envía al modelo, y donde un programa independiente lee las respuestas del modelo. Si estás dando tus primeros pasos en el mundo de la IA, GPT-4o es una buena opción, y probablemente sea un modelo que la mayoría de las personas que trabajan seriamente con IA querrán utilizar al menos en algunas ocasiones.
Claude 3.5 Sonnet. Sonnet, un modelo de segunda generación muy inteligente, destaca especialmente por su capacidad para trabajar con grandes cantidades de texto. Es parcialmente multimodal y puede trabajar con imágenes o archivos (incluidos PDF), y es capaz de generar texto o pequeños programas llamados «artefactos» que se pueden ejecutar directamente desde la aplicación. No puede generar imágenes ni voces, no puede ejecutar código de análisis de datos con facilidad y no está conectado a la web. La aplicación móvil es bastante buena, y este es el modelo que más utilizo actualmente cuando escribo. De hecho, suelo pedirle su opinión sobre las entradas de mi blog una vez que termino de escribirlas (me ayudó a encontrar una buena forma de describir los FLOP en esta entrada).
Gemini 1.5 Pro. Este es el modelo más avanzado de Google. Es parcialmente multimodal, por lo que puede trabajar con voz, texto, archivos o imágenes, y también es capaz de generar voz e imágenes (su modo de voz utiliza la conversión de texto a voz, en lugar de ser nativamente multimodal por el momento). Cuenta con una ventana de contexto enorme, por lo que puede trabajar con una inmensa cantidad de datos y también procesar vídeo. Además, puede realizar búsquedas en la web y ejecutar código (aunque a veces no queda claro cuándo puede ejecutar código y cuándo no). Resulta un poco confuso porque la interfaz web de Gemini ejecuta una combinación de modelos, pero puedes acceder directamente a la versión más potente, Gemini 1.5 Pro Experimental 0827 (como dije, los nombres son horribles), a través de Google AI Studio.
Los dos últimos modelos aún no son multimodales, por lo que no pueden trabajar con imágenes, archivos ni voz. Tampoco pueden ejecutar código ni realizar búsquedas en la web abierta. Por lo tanto, para estos modelos, no incluyo el gráfico ni las preguntas de análisis de datos. Dicho esto, tienen algunas características interesantes de las que carecen los demás modelos.
Grok 2. Proveniente de X.AI de Elon Musk, es un candidato sorpresa entre las IA. Aunque se incorporó tarde a la carrera, X está avanzando con gran rapidez por las generaciones de escalamiento gracias a estrategias ingeniosas para obtener acceso rápido a chips y energía. En este momento, Grok 2 es un modelo de segunda generación muy capaz atrapado dentro de la interfaz de Twitter/X.1 Puede extraer información de Twitter y generar imágenes mediante un generador de imágenes de código abierto llamado Flux (sin muchos filtros de seguridad, por lo que, a diferencia de otros generadores, no tiene problema en crear imágenes falsas fotorrealistas de personas reales). Cuenta con un modo «divertido» de prompt de sistema que resulta un tanto forzado, pero eso no le resta mérito al hecho de que Grok 2 es un modelo potente que ocupa el segundo lugar en el ranking principal de IA.
Llama 3.1 405B. Este es el modelo de segunda generación de Meta y, aunque todavía no es multimodal, es único entre los modelos de segunda generación porque es de pesos abiertos. Eso significa que Meta lo ha liberado al mundo, por lo que cualquiera puede descargarlo y usarlo, y, hasta cierto punto, modificarlo y ajustarlo. Debido a esto, es probable que evolucione rápidamente a medida que otros descubran formas de ampliar sus capacidades.
Ahora bien, este recorrido ha omitido muchas cosas. Por ejemplo, casi todos los modelos más potentes tienen versiones a menor escala derivadas de sus hermanos mayores. GPT-4o mini, Grok 2 mini, Llama 3.1 70B, Gemini 1.5 Flash y Claude 3 Haiku son algunas de ellas. Aunque no son tan inteligentes como un modelo de vanguardia de segunda generación, son mucho más rápidos y es más barato ejecutarlos, por lo que se usan a menudo cuando no se necesita un modelo de vanguardia completo. Del mismo modo, la ampliación de la escala no es la única forma de mejorar los modelos; existen muchos enfoques en la arquitectura de sistemas y el entrenamiento que podrían hacer que unos modelos sean mejores que otros. Sin embargo, la escala domina, al menos por ahora. Y la escala siempre ha significado embutir más «educación» en una IA: llenarla de más datos durante el proceso de entrenamiento. Pero, apenas la semana pasada, conocimos una nueva forma de ampliar la escala.
Una nueva forma de escala: el pensamiento
Cuando se presentaron los modelos o1-preview y o1-mini de OpenAI la semana pasada, se adoptó un enfoque fundamentalmente distinto respecto al escalamiento. Aunque quizás se trate de un modelo de segunda generación por la magnitud de su entrenamiento (OpenAI no ha revelado nada específico), o1-preview alcanza un rendimiento realmente asombroso en áreas específicas mediante el uso de una nueva forma de escalamiento que ocurre DESPUÉS de que el modelo ha sido entrenado. Resulta que el poder de cómputo de inferencia —la cantidad de poder de cómputo dedicada a «pensar» en un problema— también tiene su propia ley de escalamiento. Este proceso de «pensamiento» consiste, en esencia, en que el modelo realiza múltiples pasos de razonamiento interno antes de generar un resultado, lo que puede dar lugar a respuestas más precisas (la IA no piensa en un sentido real, pero es más fácil de explicar si la antropomorfizamos un poco).
A diferencia de tu computadora, que puede procesar en segundo plano, los modelos de lenguaje a gran escala solo pueden «pensar» cuando están generando palabras y tokens. Desde hace tiempo sabemos que una de las formas más eficaces de mejorar la precisión de un modelo es hacer que siga una cadena de pensamiento (con instrucciones como: primero, busca los datos; luego, considera tus opciones; después, elige la mejor opción; y, por último, redacta los resultados), ya que esto obliga a la IA a «pensar» por pasos. Lo que hizo OpenAI fue conseguir que los modelos o1 pasaran precisamente por este tipo de proceso de «pensamiento» al generar tokens de pensamiento ocultos antes de dar una respuesta final. Al hacerlo, revelaron otra ley de escalamiento: cuanto más tiempo «piensa» un modelo, mejor es su respuesta. Al igual que la ley de escalamiento para el entrenamiento, esta parece no tener límite, pero también, al igual que dicha ley, es exponencial, por lo que, para seguir mejorando los resultados, es necesario dejar que la IA «piense» durante periodos cada vez más largos. Esto hace que la computadora ficticia de La guía del autoestopista galáctico, a la que le tomó 7,5 millones de años averiguar la respuesta definitiva a la pregunta definitiva, parezca más una profecía que una broma de ciencia ficción. Nos encontramos en los albores de la ley de escalamiento del «pensamiento», pero resulta muy prometedora para el futuro.
¿Qué sigue?
La existencia de dos leyes de escalamiento —una para el entrenamiento y otra para el «pensamiento»— sugiere que las capacidades de la IA están a punto de experimentar mejoras espectaculares en los próximos años. Incluso si alcanzáramos un límite en el entrenamiento de modelos a mayor escala (lo cual parece poco probable al menos durante las próximas dos generaciones), la IA aún podría abordar problemas cada vez más complejos al asignar más poder de cómputo al «pensamiento». Este doble enfoque de escalamiento prácticamente garantiza que la carrera por una IA más potente continuará sin tregua, con implicaciones de gran alcance para la sociedad, la economía y el medio ambiente.
Con los continuos avances en la arquitectura de modelos y las técnicas de entrenamiento, nos estamos acercando a una nueva frontera en las capacidades de la IA. Es probable que los agentes de IA independientes que las empresas tecnológicas llevan tanto tiempo prometiendo estén a la vuelta de la esquina. Estos sistemas serán capaces de gestionar tareas complejas con una supervisión humana mínima, lo que tendrá implicaciones de gran alcance. Dado que parece cada vez más seguro que el ritmo de desarrollo de la IA se acelerará, debemos prepararnos tanto para las oportunidades como para los retos que nos esperan.