Debates sin resolver sobre el futuro de la IA
Hasta dónde puede llegar el paradigma actual, la IA mejorando a la IA y si seguirá teniendo sentido pensar en la IA como una herramienta
La entrada de hoy es una transcripción ligeramente editada de una charla que di hace unas semanas en la Conferencia de Innovaciones Técnicas para la Política de IA, organizada por FAR.AI. El vídeo (21 min) se encuentra en este enlace; otras charlas de la conferencia están disponibles en el canal de YouTube de los organizadores.
Transcripción y diapositivas de la charla
El problema que me llevó a dar esta charla hoy era recurrente.
Un primer ejemplo se dio en 2022, cuando tuvimos, casi al mismo tiempo, titulares acerca de que el aprendizaje profundo se topaba con un muro y, poco después, el lanzamiento de ChatGPT, que desataba una revolución totalmente nueva.
El año pasado, el Wall Street Journal publicó un reportaje —realmente bueno— sobre los desafíos reales que afrontaba OpenAI al ampliar la escala de sus modelos preentrenados, lo difícil que resultaba y cómo no estaban satisfechos con los resultados; y luego, literalmente el mismo día, se lanzó o3, la nueva generación de su modelo de razonamiento, y François Chollet —conocido por su escepticismo— afirmó que se trataba de un avance significativo en su benchmark ARC-IAG. Así que teníamos opiniones muy contradictorias, ambas con parte de verdad.
Luego, el mes pasado, aparecieron dos publicaciones importantes que imagino que muchos de los presentes habrán visto. Una defendía que la IA es simplemente una tecnología normal y que seguirá el mismo camino que hemos visto en muchas tecnologías anteriores; la otra describía cómo podríamos tener IAG para 2027, superinteligencia para 2030 y un mundo transformado de manera absolutamente radical. De nuevo, perspectivas muy diferentes, pero ambas con parte de verdad.
Así que, básicamente, esta charla es para cualquiera que… ¿Levanten la mano si alguna vez se han sentido personalmente víctimas de la avalancha de noticias sobre la IA y de lo contradictorias que son? Sí, esta charla es para ustedes. Quien no haya levantado la mano, puede irse; no me ofenderé, no pasa nada.
Un amigo vio el título de la charla y me dijo: «Un momento, ¿cómo has conseguido que te den un espacio de nueve horas para abordar todos los debates sin resolver?». Pero solo vamos a hablar de tres. Nos centraremos en los debates técnicos, es decir, en cómo evolucionará la IA como tecnología, no en qué vamos a hacer al respecto ni en cómo afectará a la sociedad. Y en los debates que, en mi opinión, son los más relevantes o que considero una forma útil de desglosar algunos de los desacuerdos.
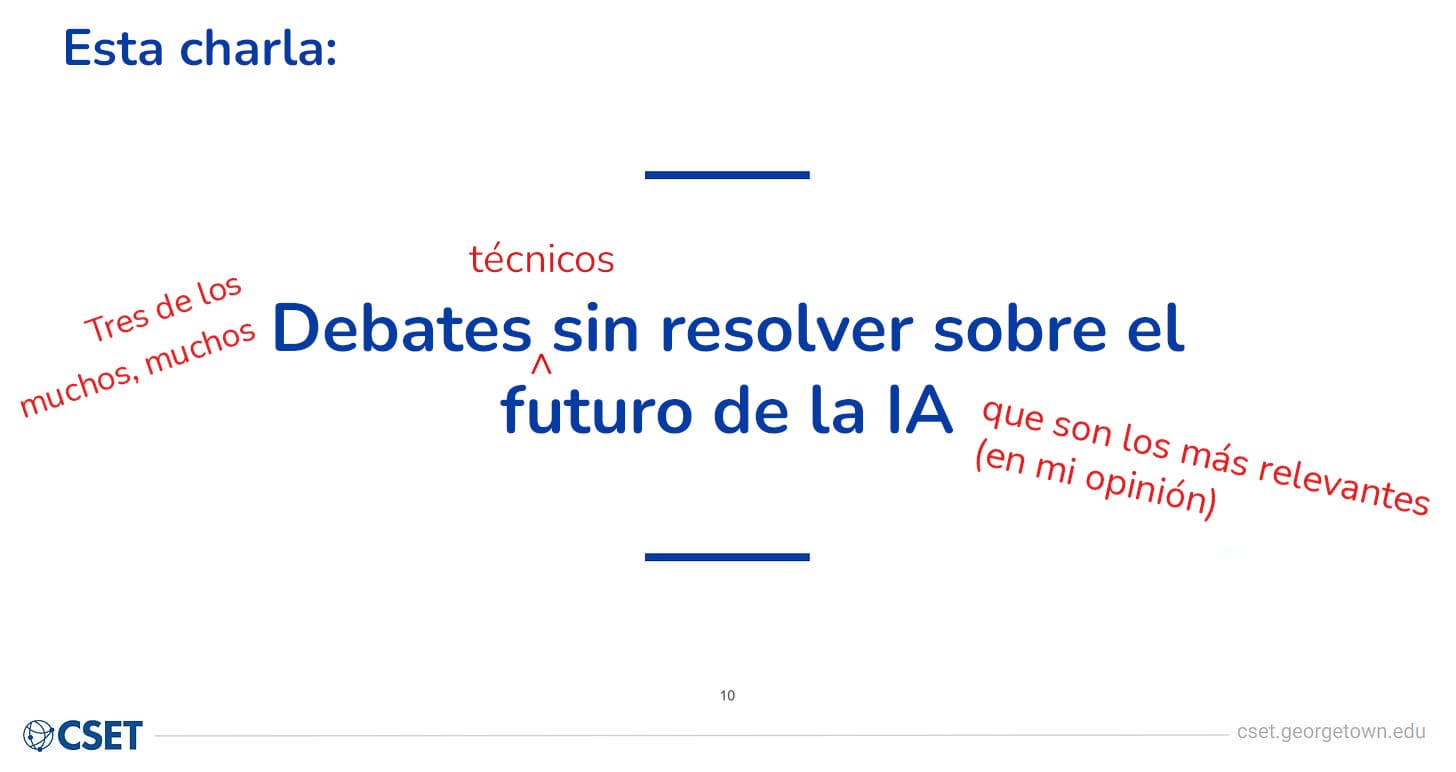
En otras palabras, no vamos a hablar de plazos para la IAG, ni vamos a hablar de p(catástrofe), porque creo que ninguno de los dos temas resulta particularmente productivo.
Estos son los tres debates de los que quiero hablar: ¿Hasta dónde puede llegar el paradigma actual? ¿En qué medida puede la IA mejorar la IA? ¿Y las IA del futuro seguirán siendo básicamente herramientas, o serán algo más?
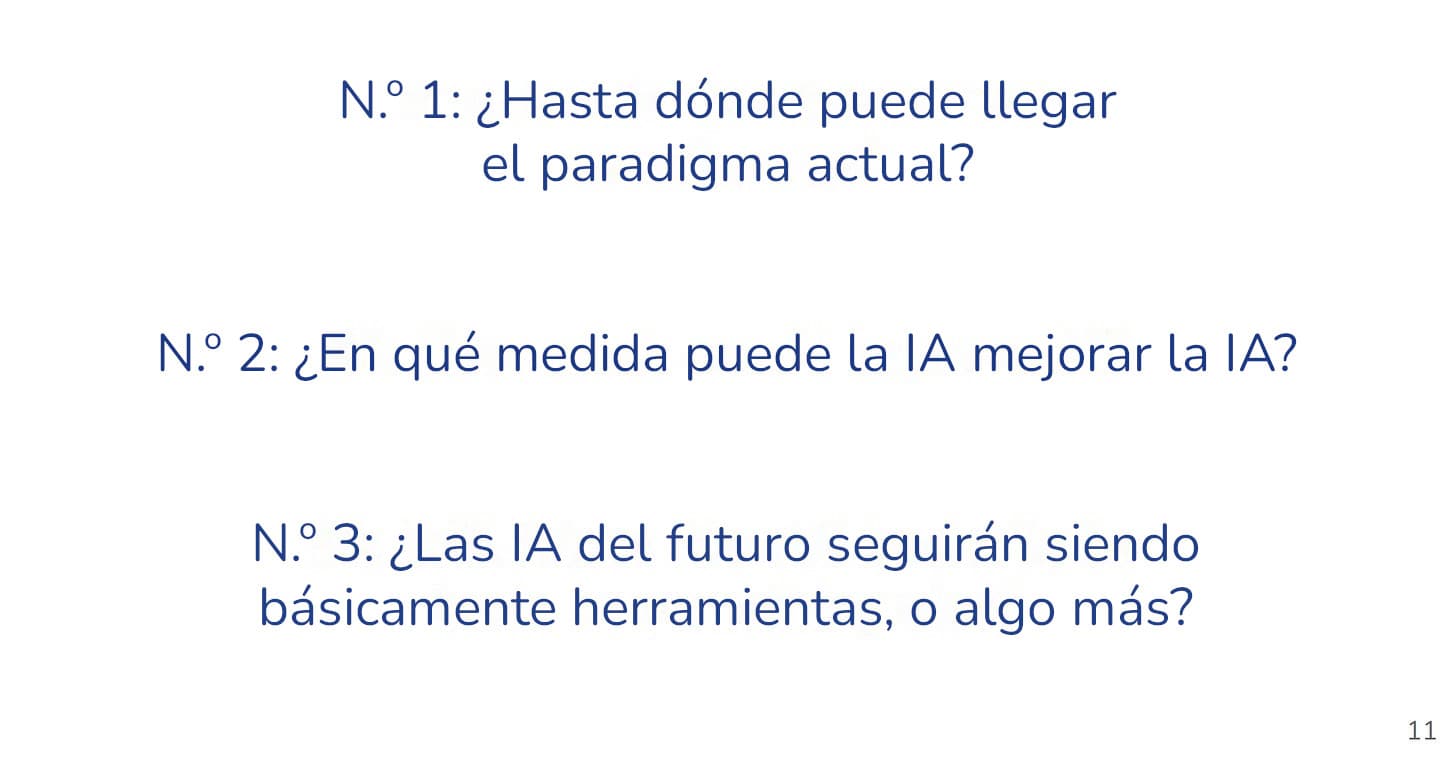
N.º 1: ¿Hasta dónde puede llegar el paradigma actual?
A menudo se habla de si «la escala es lo único que se necesita» o de si «se pueden escalar los modelos de lenguaje hasta alcanzar la IAG». No creo que sea una pregunta muy útil, o me parece un poco desacertada. Prefiero preguntar: ¿estamos en una buena rama del árbol tecnológico?
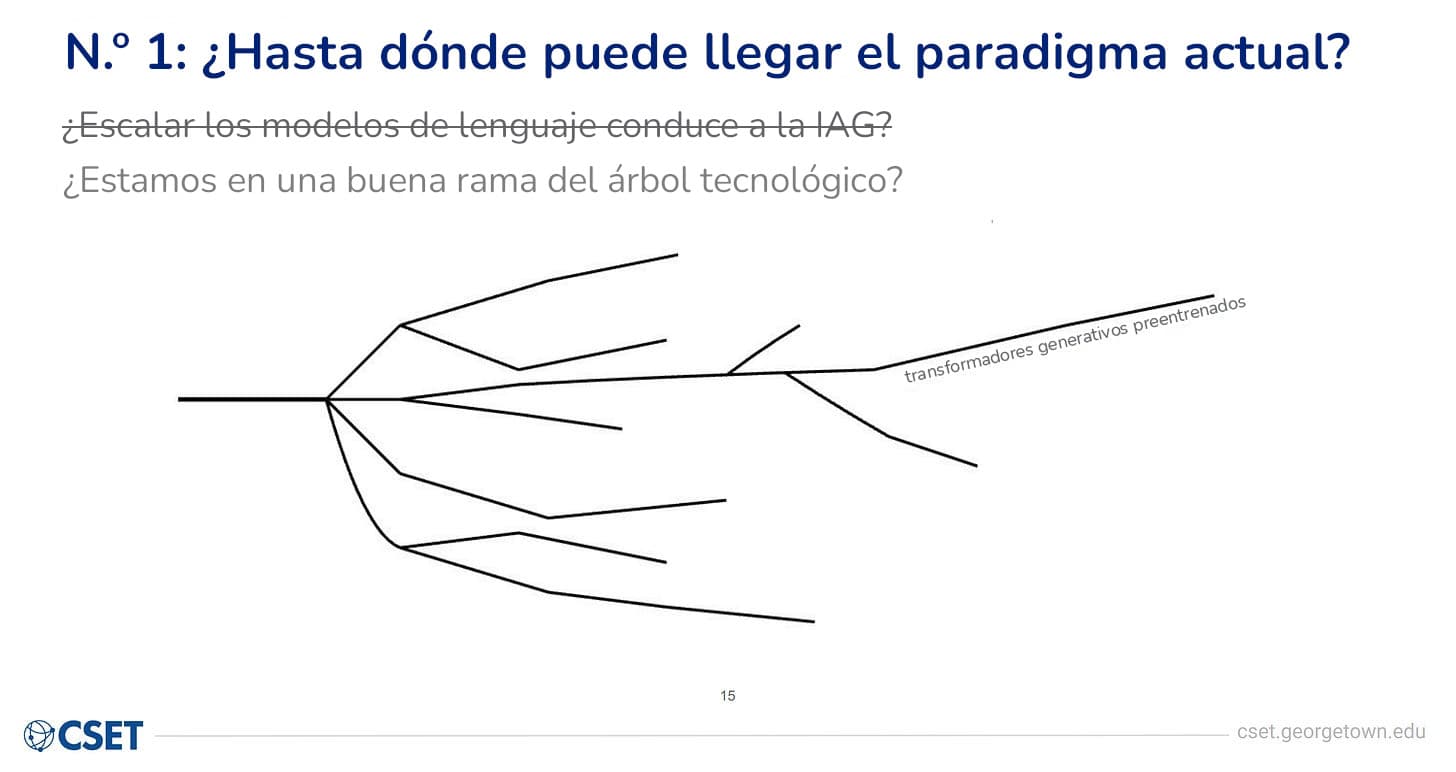
Si imaginamos que estamos explorando este árbol de posibles tecnologías por desarrollar, y que hemos explorado algunas de las vías más a fondo que otras, a la vía en la que nos encontramos actualmente se la puede llamar de diferentes maneras, pero yo la llamaré la rama de los transformadores generativos preentrenados (GPT).
La razón por la que me parece más útil es que no se trata simplemente de que hayamos tomado el GPT-1 de 2018, o algo parecido, y lo hayamos escalado. Más bien, hemos ido incorporando diferentes cambios arquitectónicos, distintas formas de recopilar y procesar datos; ahora estamos trabajando en el razonamiento, ahora en agentes…, pero todo sigue avanzando por la misma rama del árbol, o por ramas similares.
Así que, en lo que respecta a este debate —¿hasta dónde puede llegar el paradigma actual?—, si puede llegar muy lejos, eso significaría que podemos seguir avanzando por esta rama del árbol en la que nos encontramos y que esta siga dando frutos, por así decirlo, mezclando un poco las metáforas. En cambio, tal vez tengamos que dar marcha atrás y seguir por una rama algo distinta del árbol tecnológico, o quizá tengamos que retroceder mucho y tal vez ni siquiera dedicarnos al aprendizaje profundo, o bien hacer algo muy diferente a los modelos de lenguaje.
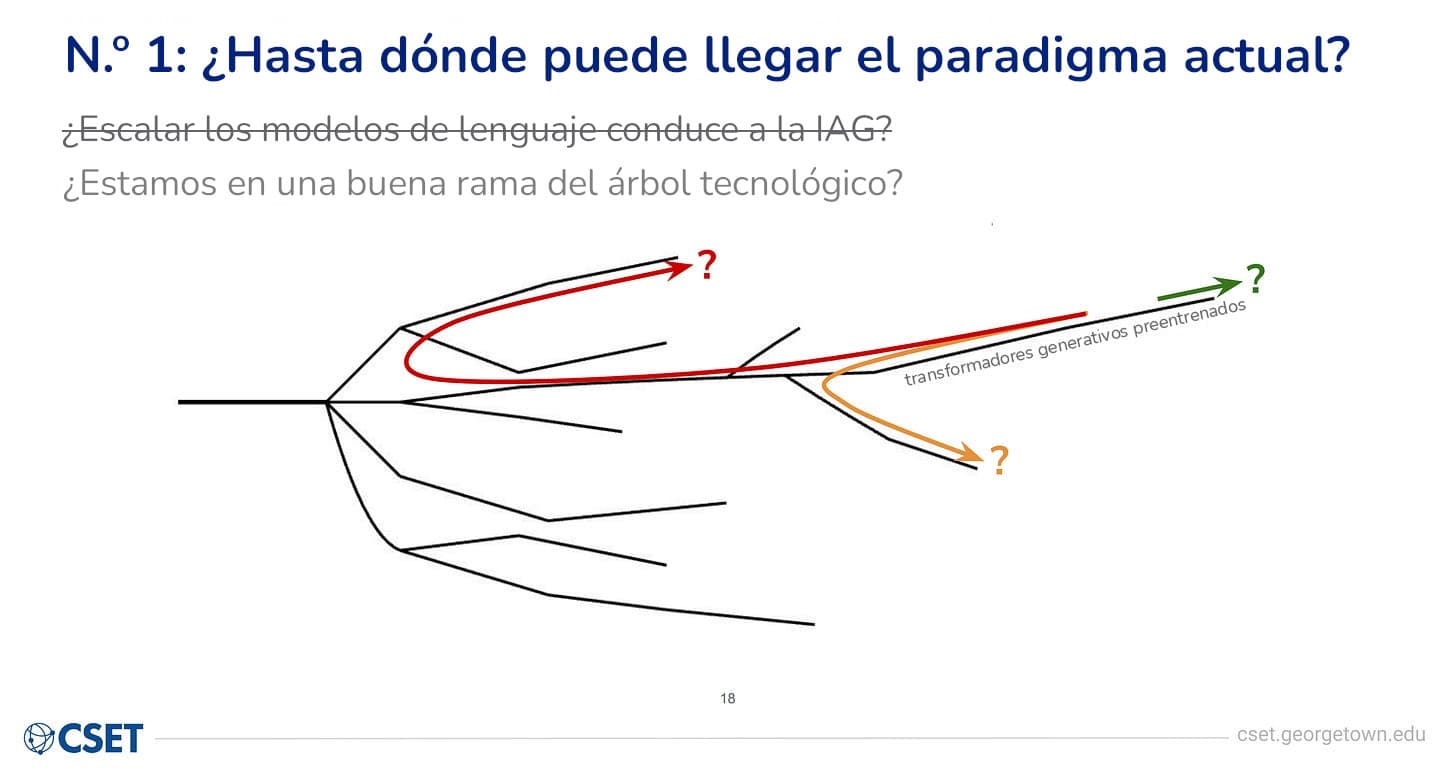
Existen diferentes argumentos sobre si podemos llegar lejos o no.
Argumentos a favor de «bastante lejos»:
-
Mejoras de pequeña a mediana envergadura. Algo realmente importante es simplemente reconocer que todos los avances que hemos visto en los últimos 10-15 años no han surgido de grandes cambios de paradigma ni de grandes descubrimientos, sino de estas distintas mejoras de pequeña a mediana envergadura. Si echamos la vista atrás a 2015-2016, cuando empezamos a lograr que el aprendizaje por refuerzo funcionara en los juegos, descubriendo cómo combinarlo con la búsqueda en árboles y superando el rendimiento humano en el Go; el transformador, que apareció en 2017 y supuso un gran hito —la base de todos nuestros modelos de lenguaje actuales—, fue una gran mejora, pero no un cambio de paradigma respecto a las LSTM (redes de memoria a corto y largo plazo); existe una larga historia de este tipo de mejoras de pequeña a mediana envergadura, por lo que es posible que sigamos viendo muchos avances gracias a ellas.
-
Encontrar cosas nuevas que se puedan escalar. A menudo la gente dice, en relación con la escalabilidad: «¿Solo tenemos que escalar lo que ya tenemos?». Pero si hablas con las personas de las empresas de IA que se dedican a esto, con los investigadores, verás que no piensan simplemente en subir el control de la escala. En cambio, consideran que una parte importante de su trabajo consiste en encontrar cosas que se puedan escalar, encontrar cosas en las que, si se aumenta la escala, se obtienen buenos resultados. Y si hablas ahora mismo con los miembros de esos equipos de investigación, creen que tienen bastantes cosas nuevas que pueden seguir escalando y en las que apenas estamos dando los primeros pasos. Cosas como el entrenamiento del razonamiento, la multimodalidad como nueva fuente de datos o descubrir formas de entrenar capacidades agentivas a gran escala. Necesitamos elementos en los que se pueda aumentar la escala y obtener buenos resultados, y parece que ahora mismo podríamos tener algunos en los que aún nos encontramos en una fase temprana.
-
Adopción —> volante de inercia de datos. Otra cosa a la que hay que prestar atención: para las empresas y los equipos de investigación que se dedican a esto, los datos son muy valiosos, y una forma realmente excelente de obtenerlos es lograr una adopción en el mundo real que luego se pueda utilizar para entrenar los futuros sistemas. Así pues, a medida que los modelos de lenguaje y las tecnologías de la rama GPT del árbol empiezan a ser útiles y a adoptarse, eso significa que vamos a obtener más de ese efecto de inercia, más de ese refuerzo.
También hay razones para pensar que el paradigma actual no nos llevará tan lejos o no seguirá avanzando mucho más.
Argumentos a favor de «no mucho más»:
-
Problemas irresolubles. Hay algunos problemas realmente importantes que han causado dificultades a los GPT en repetidas ocasiones y que siguen sin resolverse hoy en día. Estos incluyen las alucinaciones, también conocidas como confabulaciones: el mero hecho de inventarse información. La fiabilidad: existe esta brecha entre capacidad y fiabilidad en la que puedes demostrar que un sistema de IA es capaz de hacer algo muy impresionante (capacidad), pero si en realidad no lo hace el 90, 95 o 99 % de las veces (fiabilidad), puede que no resulte tan útil, dependiendo de la aplicación. Realmente no hemos visto nada que se acerque a una fiabilidad muy alta en algunas de las tareas más sofisticadas. El exceso de confianza: otro gran problema de estos modelos. Les haces una pregunta y no tienen ni idea de cuándo deben decir «no lo sé» o «lo sé». No se les da muy bien reconocer si han cometido un error y rectificar. Quizá estén mejorando, quizá no sean irresolubles para siempre, pero han resultado más difíciles de lo que algunos esperaban.
-
Limitaciones fundamentales. También existen limitaciones fundamentales en la forma en que construimos los GPT en la actualidad. Una de las principales es que pueden aprender cosas que están en sus datos de entrenamiento cuando se entrenan de esta forma masiva y de una sola vez, y luego puedes introducir elementos en su ventana de contexto para cualquier caso de uso individual, pero hoy en día no disponemos de buenas formas de hacer algo intermedio. Tener un sistema de IA que utilizas para alguna tarea en el trabajo, que la hace varias veces y mejora con el tiempo, que recuerda que hace seis meses tuviste una conversación que entonces no parecía relevante pero ahora sí lo es, que puede volver atrás y consultar sus notas, o lo que sea. Realmente no disponemos de este tipo de configuración. Se están probando cosas en las que se puede crear una base de conocimientos y hacer que la IA modifique su propia base de conocimientos, y cosas por el estilo, pero en realidad no es una parte inherente de la forma en que desarrollamos la IA en este momento, y todavía no funciona del todo bien. Asimismo, la falta de un cuerpo físico. La mayoría de los sistemas de IA que utilizamos actualmente no están integrados en sistemas físicos. Sin duda se están produciendo avances interesantes en robótica, así que, de nuevo, quizá esto cambie, pero por ahora creo que es una limitación bastante significativa.
-
Ralentización de la escala del preentrenamiento. De hecho, parece bastante claro que, con respecto a las mejoras que obtenemos simplemente al escalar el preentrenamiento —esa fase inicial de aprendizaje para imitar texto u otros tipos de datos—, el valor de seguir ampliando esa escala se está ralentizando un poco. Además, nos encontramos en un punto en el que seguir aumentando la escala supone gastar cientos y cientos de millones de dólares. Por lo tanto, si el valor obtenido no justifica esos cientos y cientos de millones de dólares, quizá resulte difícil seguir avanzando por esa curva.
Todo lo que hay a ambos lados de este balance es bastante incierto; no está claro hasta qué punto son buenos los argumentos del lado izquierdo ni los del derecho. No quiero afirmar que nada de esto sea 100 % sólido, pero creo que vale la pena tomarlo todo, al menos, con cierta seriedad.
Creo que la forma en que la gente interpreta este gráfico resume bastante bien el debate.
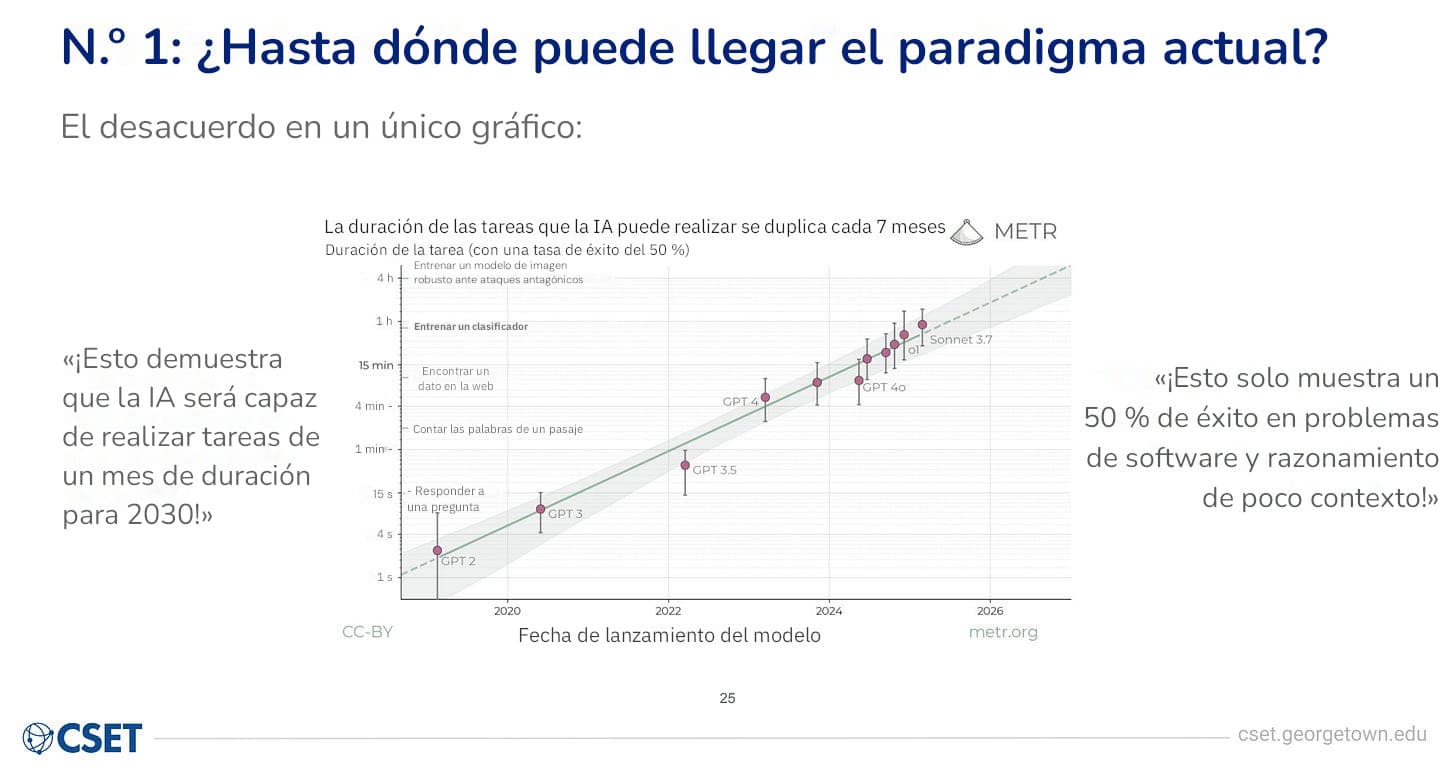
Para quien no lo haya visto, este es un gráfico de una organización llamada METR, que es un excelente evaluador independiente de IA. Crearon un conjunto de datos de tareas que a los humanos les lleva distintas cantidades de tiempo realizar. Luego, midieron el rendimiento de los distintos sistemas de IA en dichas tareas y la duración de las que son capaces de hacer bien. La idea es que, si un sistema puede realizar una tarea que a un humano le lleva una hora, esta será más difícil que una que le lleve 20 segundos. Se observa esta curva a lo largo del tiempo, en la que la duración de las tareas que pueden realizar se duplica cada siete meses. De hecho, hace poco, creo que datos aún más recientes tal vez hayan mostrado que la curva se inclina hacia arriba.
Algunas personas miran esto y dicen que demuestra que la IA puede realizar tareas cada vez más largas. Si se extrapola la curva, se obtiene que, para 2030, la IA será capaz de realizar tareas que toman un mes. Eso sería muy complejo, o mucho más complejo de lo que la IA puede hacer en este momento.
Otras personas miran este gráfico y dicen: «Bueno, pero fíjate, es una tasa de éxito del 50 %». Así que GPT-4 puede realizar una tarea de unos cinco minutos, pero solo acierta el 50 % de las veces. En la práctica, eso no es realmente útil, y si se hace el mismo gráfico con una tasa de éxito del 90 % o del 99 %, resulta mucho menos impresionante. Además, estas tareas están aisladas de su contexto. Tienen que estarlo para poder ejecutar la prueba: deben ser pequeños fragmentos aislados y manejables. Y solo son problemas de software y razonamiento, no un conjunto más amplio. Por lo tanto, una perspectiva diferente de este gráfico sería decir que en realidad no nos dice gran cosa, que solo se trata de un tipo específico de progreso en un tipo específico de problema. Y, de nuevo, creo que hay algo de cierto en ambas perspectivas, y solo el tiempo dirá cuál es la respuesta.
N.º 2: ¿En qué medida puede la IA mejorar la IA?
El segundo gran debate, que en mi opinión es fundamental para muchos otros desacuerdos, es hasta qué punto la IA será capaz de mejorar la IA.
Esta idea original fue expresada de forma concisa, quizá por primera vez, por I. J. Good, uno de los primeros informáticos en trabajar con Turing. Escribió este interesante artículo sobre las «máquinas ultrainteligentes»; estoy esperando a que ese término vuelva a ponerse de moda.
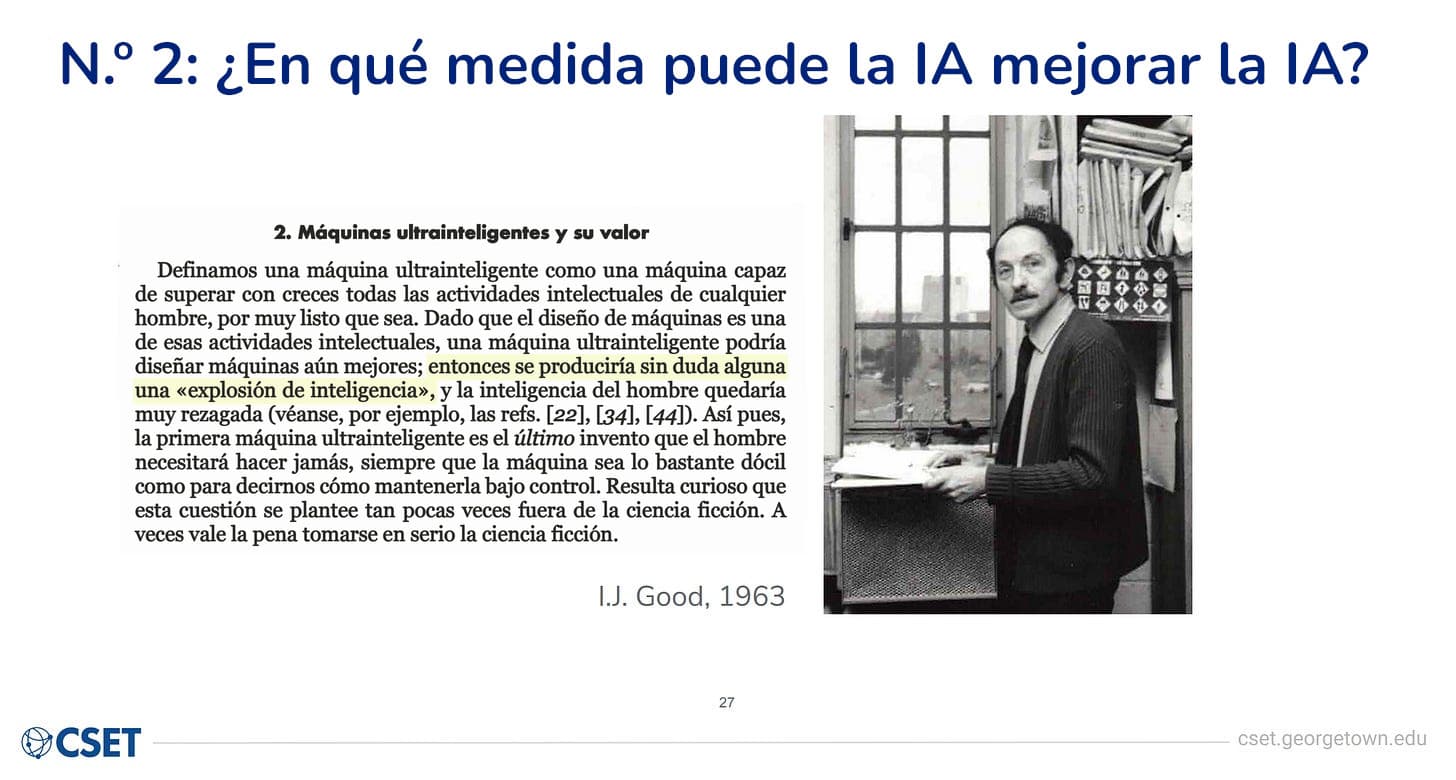
Good afirma que, si tuviéramos una máquina ultrainteligente que superara el rendimiento humano en todas las tareas, entonces sería, por lo tanto, mejor construyendo más máquinas ultrainteligentes. Así pues, «se produciría sin duda alguna una explosión de inteligencia, y la inteligencia del hombre quedaría muy rezagada». No dice nada sobre la inteligencia de la mujer, así que estamos a salvo. Es broma.
Pero esta es la idea básica. Si puedes usar la IA para mejorar la IA, y la IA llega a ser mejor que los humanos mejorando la IA, entonces se produce esta situación de bucle de realimentación con una curva en forma de palo de hockey.
Y, de hecho, esto ya está empezando a ocurrir. Good hablaba de esto hace unos 60 años, pero ahora, en tan solo los últimos años, estamos empezando a ver indicios realmente significativos de ello.
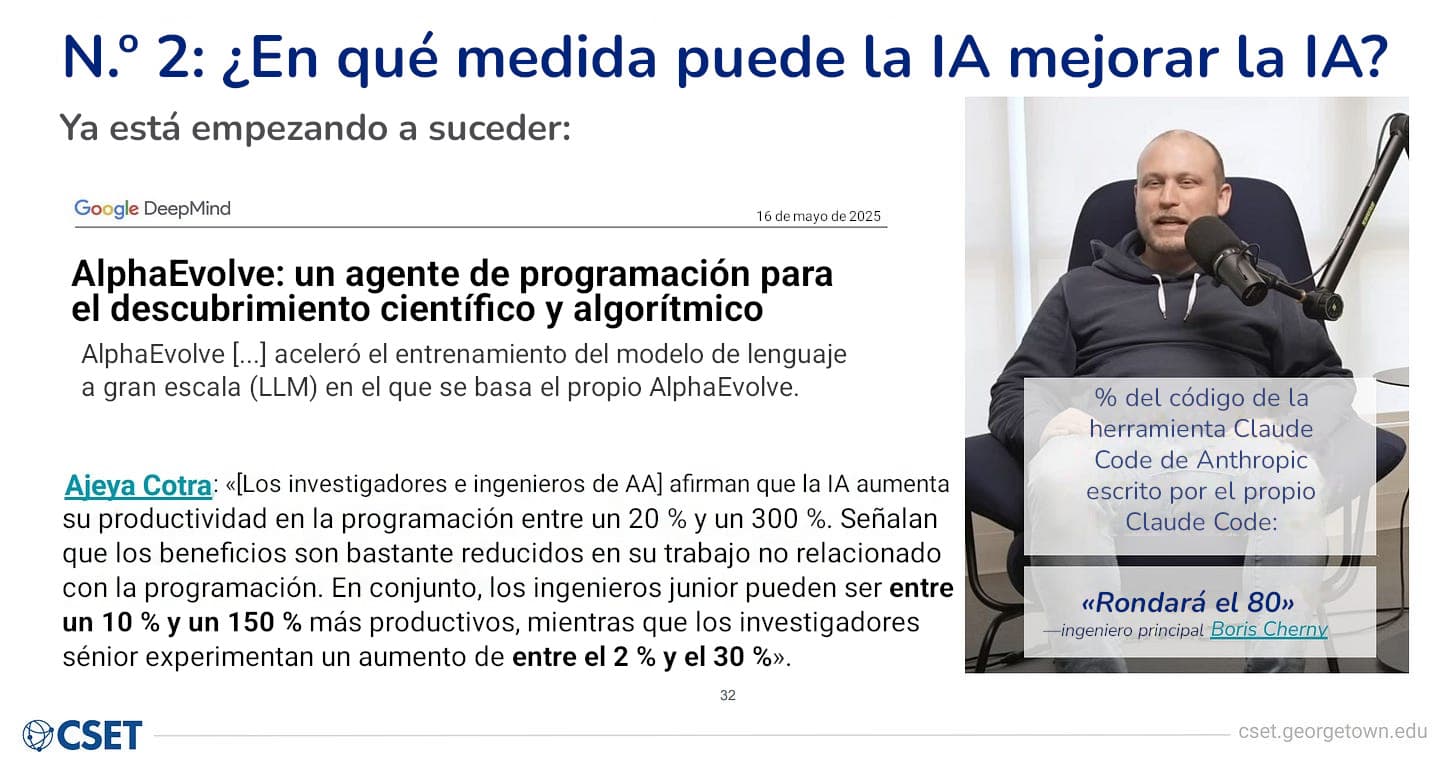
AlphaEvolve es un resultado de Google en el que utilizan sus modelos de lenguaje de vanguardia como parte de un sistema para mejorar algoritmos: el descubrimiento evolutivo de algoritmos cada vez mejores. Ese sistema logró acelerar el entrenamiento de los modelos de lenguaje a gran escala que formaban parte del sistema, por lo que, en cierto modo, se estaba mejorando a sí mismo. Creo que dijeron que aceleraron el entrenamiento de un modelo Gemini en un 1 %, y cuando se habla de cientos de millones de dólares, ese 1 % empieza a suponer una cantidad considerable.
También hay primeros resultados de una antigua compañera mía, Ajeya Cotra, que hace un trabajo realmente excelente en este ámbito. Está llevando a cabo una encuesta informal entre investigadores e ingenieros de aprendizaje automático y, según me comentó a partir de varias conversaciones, ya estaban constatando que la IA los ayudaba en su trabajo de investigación e ingeniería. El personal junior experimentaba un aumento de la productividad de entre el 10 % y el 150 % gracias al uso de herramientas de IA. Para los investigadores sénior, el aumento era algo menor, pero aun así significativo: entre el 2 % y el 30 %.
Luego, justo cuando me estaba preparando para esta charla, encontré esta estadística bastante interesante. Claude Code es una herramienta de Anthropic que ayuda a los desarrolladores a programar (utilizando Claude, de ahí el nombre). Este es el ingeniero jefe de ese proyecto, y él dijo en un pódcast que, del código que sustenta el propio Claude Code, el porcentaje escrito por Claude era «probablemente cercano al 80 [%]». Así pues, una proporción muy grande de esta herramienta de programación fue escrita por la IA que la hace funcionar.
Pero, aun así, en realidad no sabemos hasta dónde llegará esto. Por eso surge una pregunta: si la IA puede hacer todo lo que hacen los investigadores e ingenieros de IA, entonces se produce naturalmente este bucle de realimentación en el que todo está limitado únicamente, por ejemplo, por el poder de cómputo disponible. Pero si te topas con otros cuellos de botella, si hay otros factores que ralenticen el proceso, entonces quizá no se produzca ese crecimiento recursivo en forma de palo de hockey.
Algunos posibles cuellos de botella:
-
Errores que requieren revisión humana: En este momento, el principal es que las herramientas de programación (o las herramientas de investigación, o cualquier IA que se utilice para la investigación en IA) cometen errores, por lo que hay que revisarlas. Esta es una gran razón por la que la productividad que esos investigadores indicaban en la diapositiva anterior aún no es tan alta. Todavía tienen que supervisar todo lo que hace la IA, ejecutar pruebas, comprobar que las pruebas funcionen, etc.
-
Criterio/juicio en la investigación: En el futuro, quizá haya menos errores, pero si la IA se limita a programar o a ejecutar instrucciones bastante sencillas, no necesariamente tendrá la clase de criterio o juicio investigativo que se necesita para automatizar realmente ese ciclo completo de investigación e ingeniería.
-
Experimentos y/o implementaciones en el mundo real: Y, aunque eso se pudiera automatizar, quizá haya experimentos en el mundo real que sea necesario llevar a cabo, o implementaciones en el mundo real; quizá sea necesario introducirla realmente en una organización o empresa real para ver qué funciona y qué no, y obtener esa retroalimentación.
Así que todos esos podrían ser cuellos de botella. Pero, por otra parte, ¿qué grado de certeza tenemos de que todos estos cuellos de botella no puedan automatizarse? No estoy seguro al 100 %. Creo que es una situación de esperar y ver. El tiempo dirá cuáles de estos son realmente cuellos de botella y cuáles pueden automatizarse en la práctica.
N.º 3: ¿Las IA del futuro seguirán siendo básicamente herramientas, o algo más?
El tercer desacuerdo se refiere a los futuros sistemas de IA y a si tendrá sentido considerarlos herramientas.
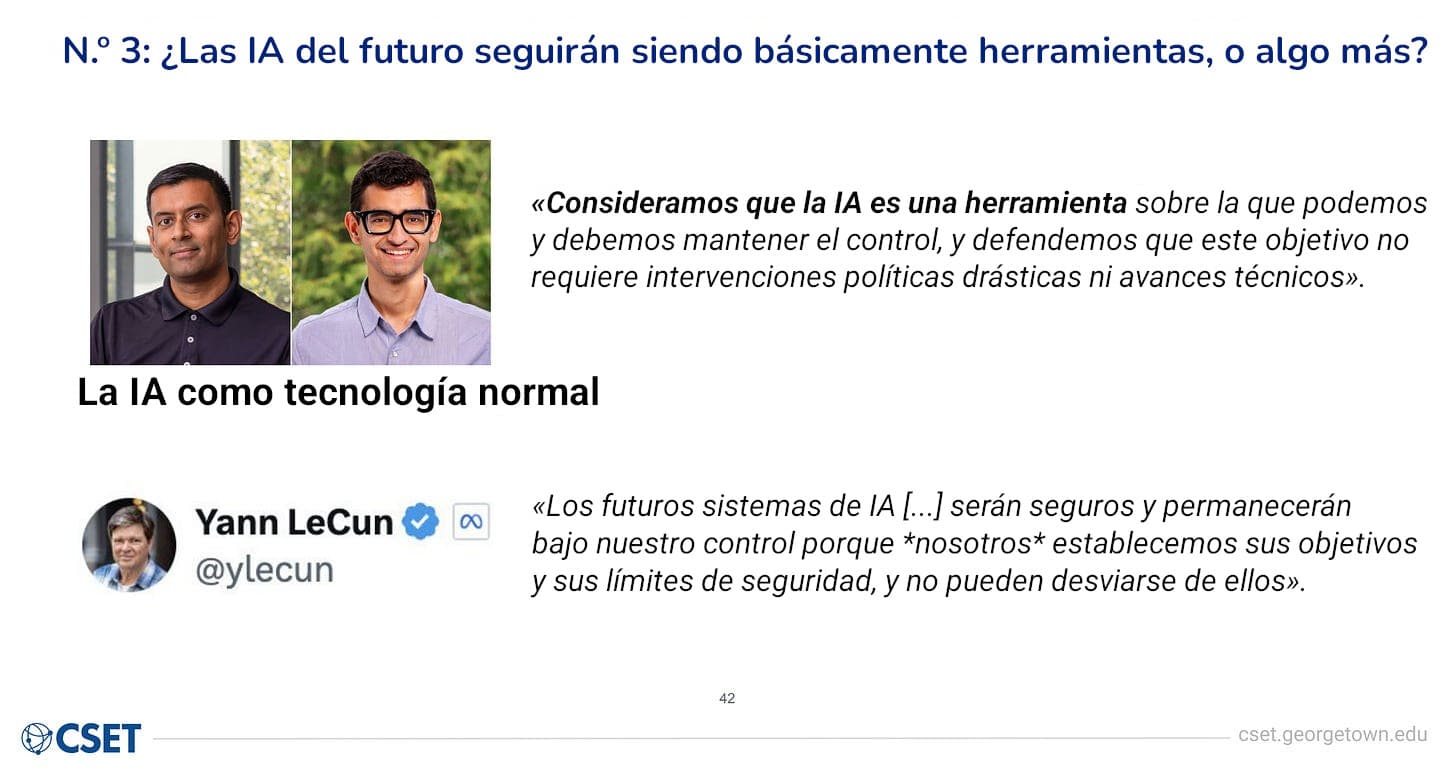
El artículo «AI As Normal Technology», que recomiendo encarecidamente, es obra de Arvind Narayanan y Sayash Kapoor, de Princeton, autores del blog AI Snake Oil. Es muy completo y contiene muchas exposiciones muy acertadas de posturas que, en mi opinión, mucha gente mantiene intuitivamente sobre la IA, pero que no necesariamente ha expresado. Dicen: «Consideramos la IA como una herramienta sobre la que podemos y debemos mantener el control».
Otro famoso escéptico respecto al riesgo asociado a la IA, Yann LeCun, ha expresado una perspectiva similar: «Los futuros sistemas de IA […] serán seguros y permanecerán bajo nuestro control porque *nosotros* establecemos sus objetivos y sus límites de seguridad, y no pueden desviarse de ellos».
Creo que es muy importante que cualquiera que no conciba la IA de esta manera, o que no conciba así los sistemas de IA más avanzados del futuro, dedique un tiempo a reflexionar sobre el hecho de que este es realmente un punto de partida muy razonable. Es la forma en que funcionan prácticamente todos los sistemas de IA hoy en día, es la forma en que funcionan la mayoría de las tecnologías, y también es algo con lo que tenemos experiencia.1
Así pues, si parece que la IA va a seguir siendo una herramienta cuyo uso determinamos nosotros —abres tu aplicación de ChatGPT, escribes una pregunta, te responde, cierras la aplicación y ya está—, eso significa que las cosas van a ser bastante más sencillas en muchos aspectos. Si esto es cierto, entonces no tenemos que dedicar demasiado tiempo a preocuparnos por los objetivos del sistema de IA ni por los valores que tiene. Sigue siendo algo relevante; si haces una pregunta sobre algún tema político, te sigue importando qué tipo de respuestas obtienes, pero eso tiene menos que ver con la naturaleza de la propia IA y más con el contenido.
Del mismo modo, si los sistemas de IA siguen siendo herramientas, entonces las personas van a ocupar un lugar realmente central. No se trata de qué quiere la IA ni de qué va a hacer; se trata de quién utiliza la IA y de qué va a hacer con ella. Quizá sigamos preocupándonos por los fallos de funcionamiento o los errores, pero sigue siendo mucho más comparable a las tecnologías del pasado.
Pero… creo que sí hay algunos aspectos de la IA que son bastante diferentes a los de las tecnologías del pasado.
Una es esta idea, que escucharán con bastante frecuencia por parte de los investigadores, de que los sistemas de IA se cultivan, no se construyen.
Lo que quieren decir con esto marca un contraste con, digamos, un smartphone: este está compuesto por pequeños componentes, los ensamblamos, y realmente entendemos a un nivel muy detallado cómo funciona cada uno de ellos y cómo encajan entre sí para fabricar un smartphone que hace todas las cosas complicadas que hace un smartphone.
En lo que respecta a la IA, los sistemas de aprendizaje automático, los sistemas de aprendizaje profundo y los modelos de lenguaje a gran escala, en realidad no es así en absoluto como se desarrollan. En su lugar, tenemos algoritmos que ejecutamos sobre datos, utilizando procesos de optimización matemática que ajustan miles de millones o billones de números, y terminamos obteniendo algo que parece funcionar. Podemos probarlo y ver qué hace o cómo parece comportarse, pero en realidad no tenemos esa comprensión componente por componente a la que nos tienen acostumbrados las tecnologías. Eso lo convierte en algo un poco más parecido a un sistema orgánico —una planta, un animal, o incluso una simple bacteria—, en lugar de algo que nosotros mismos construimos pieza por pieza.
También hay algo realmente inusual en los sistemas de IA que ha empezado a surgir en los últimos uno o dos años, y es la idea de la conciencia situacional. No se trata de la consciencia ni de ningún gran concepto filosófico; la conciencia situacional se reduce simplemente a: ¿parece la IA capaz de tener en cuenta la situación en la que ella misma se encuentra?
Algo que estamos empezando a observar son sistemas de IA que notan y comentan el hecho de que una situación de prueba en la que se los coloca, algún escenario hipotético extraño, parece ser una prueba. Así pues, si pueden percibir que están en una situación de prueba y se comportan de forma diferente porque creen estar en una, eso en cierto modo anula el propósito de la misma. No estamos nada acostumbrados a que las tecnologías se comporten de esta manera. Esto no es en absoluto lo que haría tu smartphone si estuvieras realizando, digamos, alguna prueba para asegurarte de que sobrevive al agua; no reaccionaría diciendo: «Vaya, me están poniendo a prueba, así que me comportaré en el agua de forma distinta a como lo haría normalmente». Esto es algo realmente inusual cuando consideramos a las tecnologías como herramientas.2
Una última cuestión, que es algo para el futuro, es que existen incentivos financieros y comerciales muy fuertes para construir sistemas de IA que sean muy autónomos y muy generales. Sistemas a los que se les puedan encomendar tareas de visión global, de alto nivel, a largo plazo y complicadas, y dejar que salgan a realizarlas de forma autónoma sin mucha revisión y sin demasiadas restricciones.
Puede que resulte inviable crear sistemas de IA que funcionen así. O puede que logremos actuar con decisión y determinar que no queremos crear sistemas de IA que funcionen de esa manera. Sin embargo, creo que el camino predeterminado que debemos esperar es que existan incentivos realmente fuertes para hacerlo; por lo tanto, si es técnicamente posible y no se produce una intervención significativa, ese es el tipo de sistemas que acabaremos teniendo.
Y si eso es cierto, y tenemos sistemas muy autónomos y muy generales que operan en contextos complejos, entonces no tendrá mucho sentido considerarlos herramientas.
Una cita que me resultó útil al respecto es de Jack Clark, cofundador de Anthropic, donde dirige el departamento de políticas. Este es un extracto de un artículo más extenso de su Substack, ImportAI, que me pareció muy profundo; escribió (énfasis añadido):
Debemos esperar que la voluntad de independencia sea un resultado directo del desarrollo de sistemas de IA a los que se les pide realizar una amplia gama de tareas cognitivas complejas. […] Aquí no estamos creando herramientas tontas, estamos entrenando mentes sintéticas. Estas mentes sintéticas tienen un valor económico que crece en proporción a su inteligencia.
Lo que me gusta de esta cita es que no dice que vayamos a crear personas, que vayan a ser conscientes, que vayan a tener sentimientos; quizá algunas de esas cosas sean ciertas, quizá no, pero de eso no estamos hablando aquí. A lo que se refiere Jack es simplemente al hecho de que estemos entrenando sistemas para realizar tareas difíciles y de gran valor económico de formas muy versátiles y abiertas, lo cual implica que podríamos observar comportamientos de apariencia extraña que realmente no son propios de una herramienta. Podríamos observar esto en los sistemas de IA y, repito, ya estamos empezando a vislumbrar los primeros indicios.
Creo que estas son razones para esperar que, si la tecnología sigue avanzando, tal vez deje de parecer una herramienta y pase a parecerse a algo un poco diferente, quizá más parecido a lo que a veces se denomina una «segunda especie».
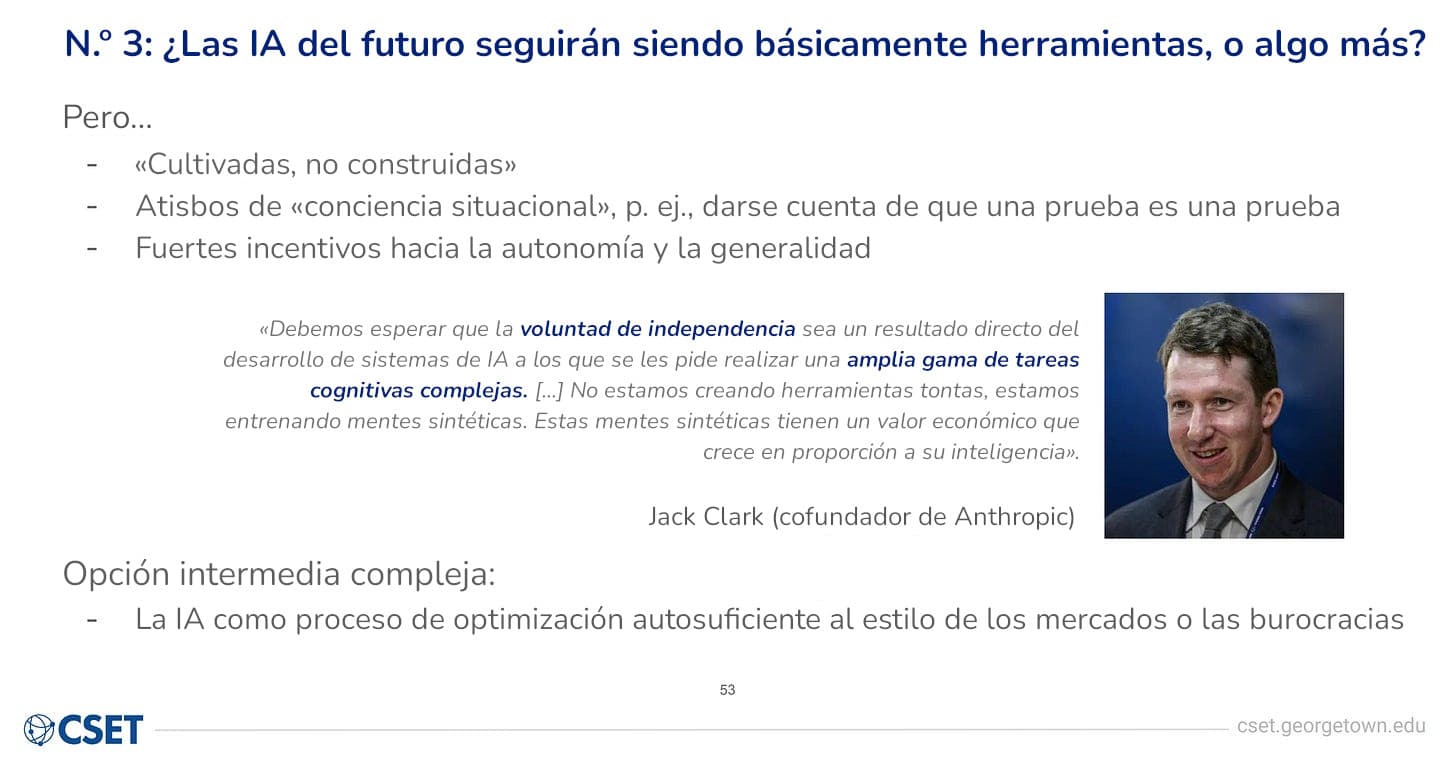
Una reflexión final para este tercer debate: si por un lado se afirma que «claramente va a ser solo una herramienta» y por el otro se sostiene que «va a ser algo así como una segunda especie», una posición intermedia que quizá ya estemos empezando a vislumbrar podría consistir en concebir la IA como un proceso de optimización, tal vez un proceso de optimización autosuficiente, del tipo que quizá sea un mercado o una burocracia. No es una herramienta, no es algo que simplemente se toma, se usa, se deja a un lado y ya no hace nada; tampoco es necesariamente un ser o una mente, pero sigue siendo muy poderosa y quizá tenga sentido pensar en qué es lo que está optimizando, qué tipo de objetivos tiene y qué es probable que haga en el futuro, en lugar de considerarla simplemente una herramienta. Creo que esta también es una forma de pensar en este espectro de posibilidades que suena un poco menos a ciencia ficción.
Conclusión
Aquí lo dejaré por hoy. Parece que tenemos tiempo para un par de preguntas. Espero que estos tres debates resulten útiles para desglosar algunos de los debates irresolubles y, a veces, poco productivos en este ámbito.